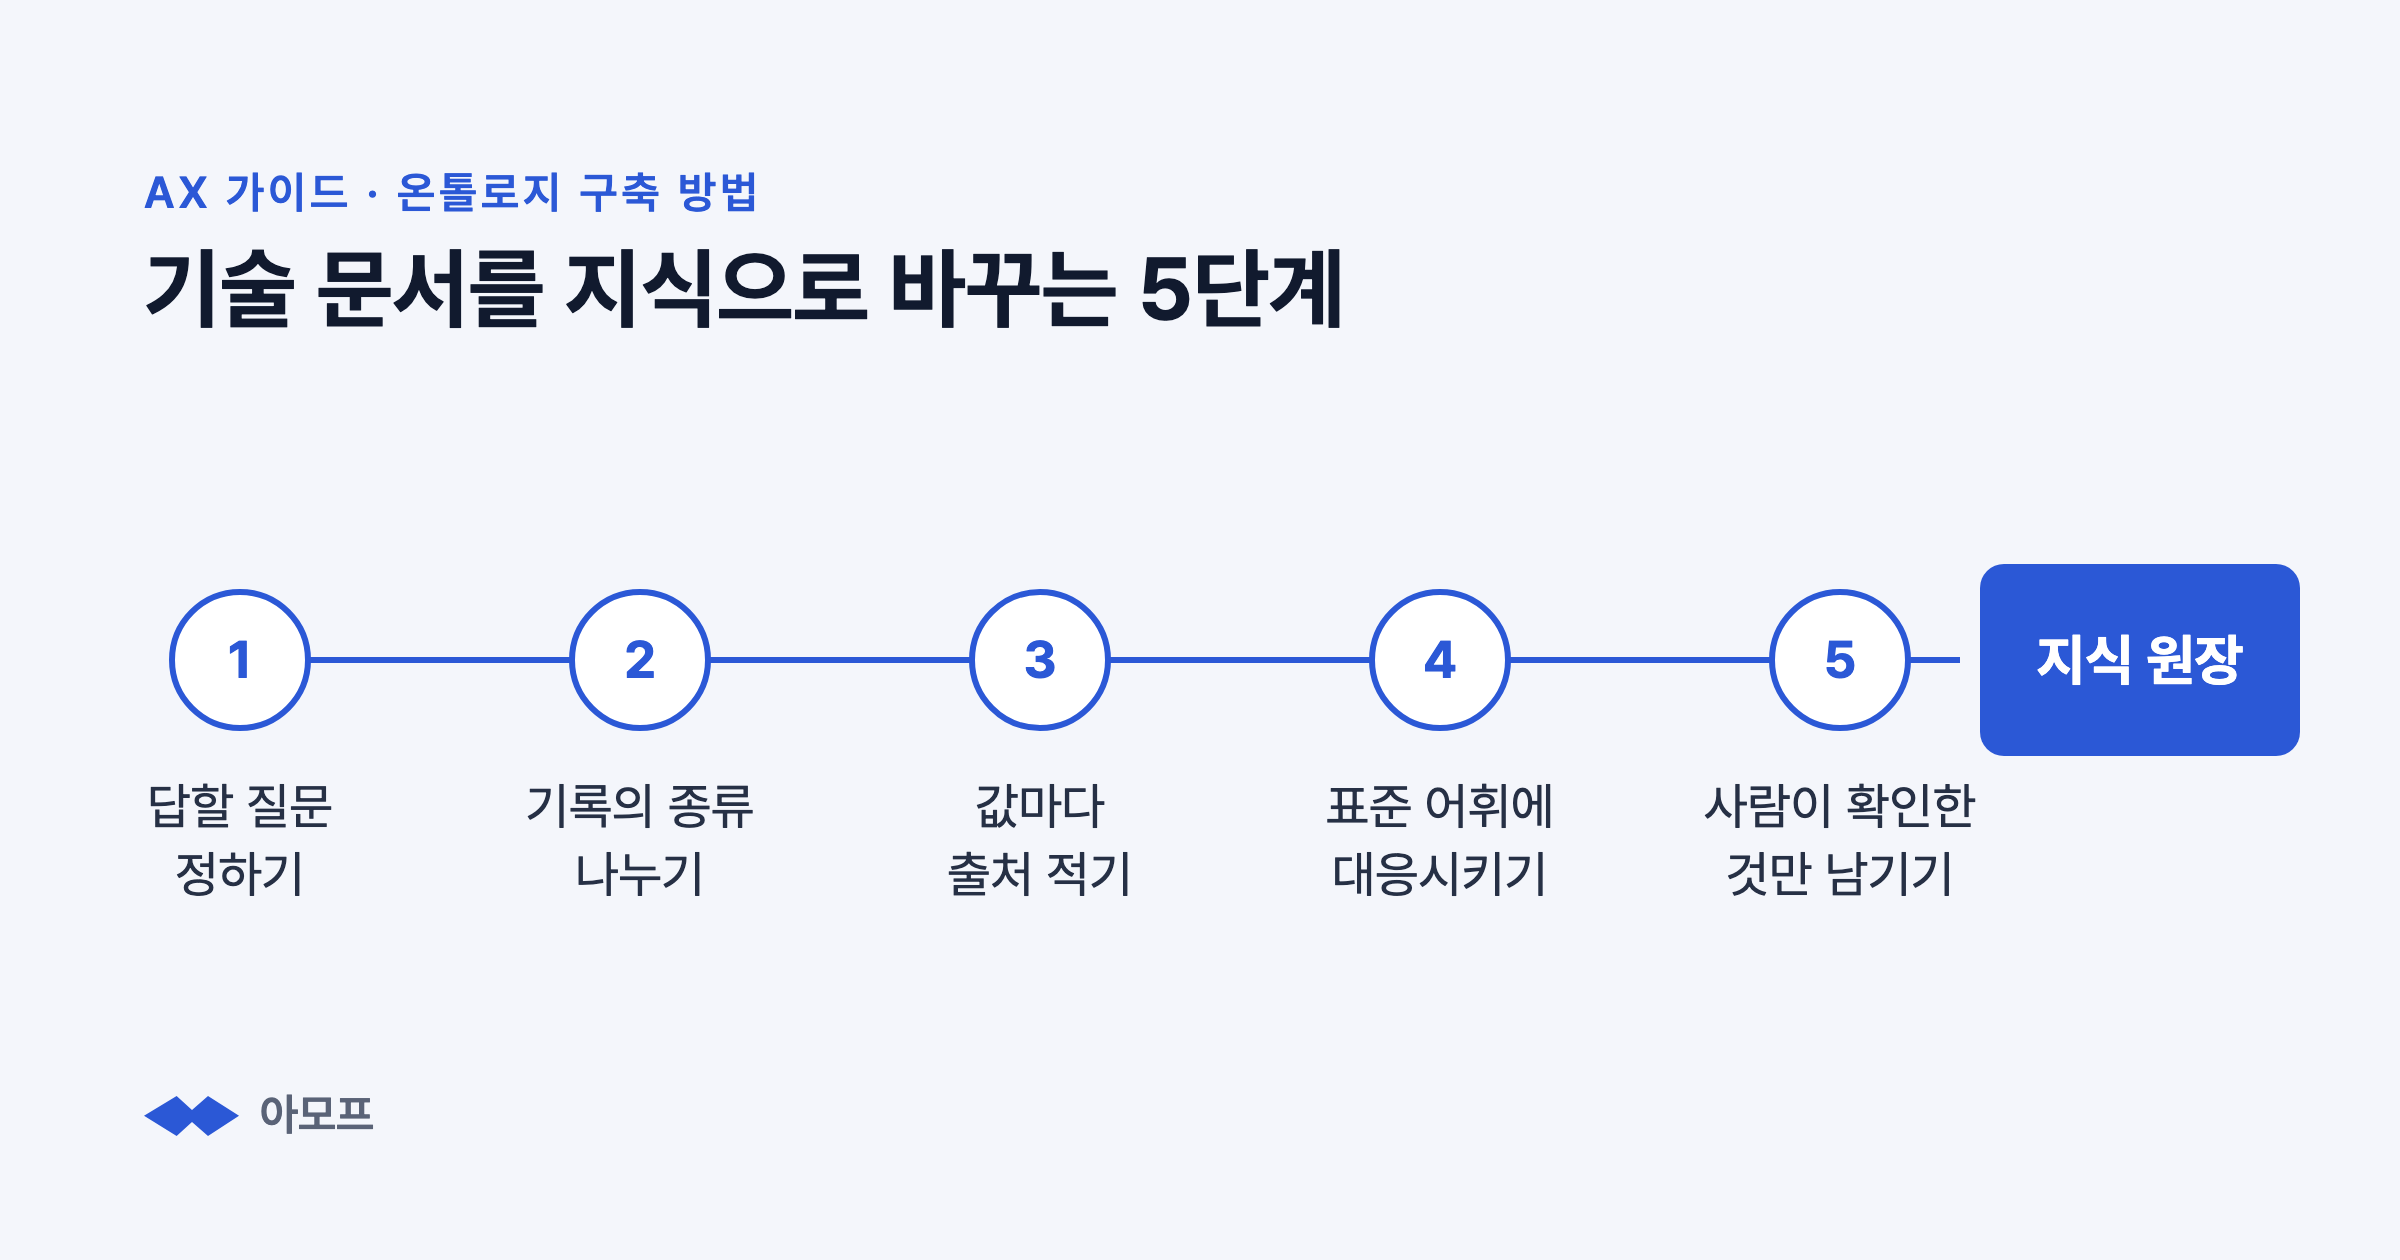
온톨로지 구축은 업무에서 쓰는 개념과 개념 사이의 관계를 미리 정의해 지식의 틀인 온톨로지를 만들고, 문서에서 읽은 사실을 그 틀에 맞춰 기록하는 일입니다. 아모프는 답할 질문 정하기, 기록의 종류 나누기, 값마다 출처 적기, 표준 어휘에 대응시키기, 사람이 확인한 것만 남기기의 다섯 단계로 온톨로지를 만듭니다.
이 다섯 단계는 아모프 창업팀이 만든 지식 AI 시제품의 설계와 시험에서 내린 결정을 순서대로 정리한 것입니다. 창업팀은 2026년 9월부터 10월까지 기술 문서와 공개 논문을 읽고 사람이 확인한 내용만 지식으로 쌓는 이 시제품을 만들었습니다. 시제품은 한 컴퓨터에서 실행되며, 공개 논문과 시험용 문서로 시험했을 뿐 실제 회사의 업무에 쓴 결과가 아닙니다.
1단계: 온톨로지로 답할 질문을 먼저 정합니다
온톨로지의 틀을 정하기 전에, 그 지식으로 답해야 할 질문부터 적습니다. 아모프 창업팀은 "이 조건에서 무엇이 보고되었는가"를 묻는 질문과 "조건을 바꾸면 무엇이 예상되는가"를 묻는 질문을 나눠서 답하도록 시제품을 설계했습니다.
답해야 할 질문의 목록을 먼저 적어 온톨로지의 범위를 정하는 방법은, 스탠퍼드 대학의 노이와 맥기니스가 쓴 온톨로지 입문 안내서에도 첫 단계인 범위 정하기의 한 방법으로 나옵니다(Noy·McGuinness, 2001). 이 안내서는 이런 질문을 역량 질문(competency question)이라고 부르고, 나중에 온톨로지가 그 질문에 답할 만큼 정보를 담았는지 확인하는 시험으로 씁니다.
시제품은 질문에 답하는 방식을 다음 세 가지로 나눴습니다.
- 기록에서 답을 찾는 조회
- 시료(실험에 쓰는 재료의 견본)와 분석법, 측정 기준, 운전 방식(설비를 돌리는 방식)이 서로 맞는지 따지는 적용 가능성 판단
- 등록된 계산 모형으로 하는 예측(시제품에는 아직 구현하지 않았습니다)
2단계: 기록의 종류와 같은 기록인지 판단할 기준을 정합니다
문서에서 읽을 사실을 시료, 실험, 관측 같은 기록의 종류로 나누고, 두 기록이 같은 대상인지 판단할 식별 기준을 정합니다. 시제품은 두 기록이 같은지를 문장이 얼마나 비슷한지가 아니라, 미리 정한 식별 기준으로만 판단합니다.
여기서 관측은 무엇을 재거나 보고한 값 하나를 담는 기록이고, 식별 기준은 두 기록이 같은 대상을 가리키는지 판단할 때 비교하는 항목입니다. 두 논문에 같은 시료 이름이 나와도 같은 시료라는 보장은 없으므로, 같은 대상인지 가르는 기준을 먼저 정하지 않으면 이름만 같은 다른 시료의 값이 한 기록으로 섞입니다.
- 논문처럼 고유한 식별 번호가 붙은 자료는 그 번호로 출처를 구별하는 편이 안전합니다. DOI는 논문 같은 자료에 하나씩 붙어 그 자료를 고유하게 가리키는 식별 번호이며(DOI Foundation), 국제 표준 ISO 26324로 정해져 있습니다.
- 시험 성적서는 제품이나 재료를 시험한 결과를 적은 문서입니다. 이 글의 시제품을 시험할 때 쓴 규격과 성적서는 시험용으로 지어낸 자료였습니다.
3단계: 값마다 출처와 성격을 나눠 적습니다
같은 숫자라도 논문이 보고한 값과 직접 잰 값은 서로 다른 사실이므로, 값마다 둘 가운데 어느 쪽인지 구분하고 측정한 값인지 다른 값에서 계산한 값인지도 따로 적습니다. 원문에 실험 날짜가 없으면 논문의 출판일로 채우지 않고 "미상"으로 둡니다.
- 출처의 종류에 따라 근거로 삼을 수 있는 기록이 다릅니다. 예를 들어 뉴스 기사는 규격이나 실험 기록의 근거로 삼기 어렵습니다.
- 설정한 온도와 실제로 잰 온도는 서로 다른 기록으로 둡니다.
- 단위는 바꾸지 않고 원문 그대로 둡니다. 시간을 h(시간)로 적은 기록과 min(분)으로 적은 기록처럼 단위가 다르면 값을 비교하지 않고 "판정불가"로 답합니다. 판정불가는 근거가 부족하거나 단위나 시험법이 달라서 기준을 충족하는지 판단할 수 없을 때, 충족과 미충족 대신 내는 세 번째 답입니다.
- 논문의 표에서 수치를 읽는 방법은 "AI는 논문 PDF의 표에서 수치를 제대로 읽을 수 있나요?"에서 설명합니다.
4단계: 표준 어휘에 대응시킵니다
기록의 종류와 칸마다 공개된 표준 어휘에서 같은 뜻을 가진 개념을 찾아 대응표를 만듭니다. 표준 어휘는 표준 단체나 비영리 단체가 개념과 관계에 이름을 붙여 공개한 목록이어서, 여러 기관의 자료를 같은 뜻으로 맞춰 읽는 기준이 됩니다.
기록에 자주 쓰는 표준 어휘와 관련 용어는 다음과 같습니다.
- SOSA/SSN은 센서와 관측, 관측 방법, 관측 대상, 시료, 관측한 성질을 기술하는 온톨로지입니다. 웹 표준을 만드는 국제 비영리 단체 W3C와 지리 공간 정보의 표준을 만드는 국제 단체 OGC가 함께 만들었고, W3C는 2017년 10월 19일 이를 표준 문서인 권고안으로 발표했습니다(W3C·OGC, 2017).
- PROV-O는 데이터를 만드는 데 관여한 대상과 활동과 사람, 즉 데이터의 출처와 이력을 기술하는 W3C의 표준 어휘입니다(W3C, 2013).
- QUDT는 측정 단위와 물리량의 종류를 기계가 읽을 수 있게 정의한 공개 어휘이며, 비영리 단체 QUDT.org가 관리합니다(QUDT.org).
- OWL은 온톨로지를 적는 W3C의 표준 언어이고(W3C OWL 2 개요, 2012), 추론기는 OWL로 적은 내용에서 새 정보를 끌어내는 도구입니다(W3C OWL 2 입문서, 2012).
세 어휘는 다루는 대상이 서로 달라서, 관측은 SOSA/SSN, 출처와 이력은 PROV-O, 물리량과 단위는 QUDT처럼 기록의 성격에 맞는 어휘를 골라 씁니다.
세 어휘의 대표 개념은 다음과 같습니다.
| 어휘 | 대표 개념 | 담는 것 |
|---|---|---|
| SOSA/SSN | sosa:Observation, sosa:Sample | 관측과 그 결과, 관측 대상을 대표하는 시료 |
| PROV-O | prov:Entity, prov:Activity, prov:Agent | 데이터 같은 결과물, 그것을 만든 활동, 관여한 사람이나 조직 |
| QUDT | qudt:QuantityValue, qudt:Unit | 수치와 단위 |
이미 있는 어휘를 다시 쓰는 일은 앞의 안내서가 둘째 단계로 권하는 일이기도 합니다. 안내서는 다른 시스템과 자료를 주고받아야 한다면, 그 시스템이 이미 쓰는 어휘를 따르는 일이 꼭 필요할 수도 있다고 설명합니다(Noy·McGuinness, 2001).
5단계: 사람이 확인한 것만 기록하고, 부족한 지식은 사람에게 묻습니다
AI가 제안한 기록 후보는 인용과 수치를 원문과 대조하는 검사를 통과한 뒤에도, 담당자가 원문 인용과 그 위치를 확인하고 확정 버튼을 눌러야 지식 원장에 들어갑니다. 지식 원장은 사람이 확인한 기록만 시간 순서대로 덧붙여 쌓는 데이터베이스입니다.
시제품은 정의가 없는 용어나, 이름은 같은데 설명이 다른 지식을 찾으면 같은 대화 안에서 사람에게 보충을 요청합니다.
- 채팅에서 "맞다"고 답하는 것만으로는 아무것도 기록되지 않습니다.
- 확정 기록에는 누가 어떤 역할로 확정했는지가 함께 남아야, 나중에 그 기록을 누가 책임지는지 되짚을 수 있습니다.
- 설명이 서로 다르면 어느 하나를 지우지 않고, 두 출처를 나란히 보여 줍니다. 문헌마다 재료와 실험 조건이 달라서 두 설명이 모두 맞을 수 있기 때문입니다.
- 전문가가 값을 바로잡아도 논문이 보고한 원래 값은 지우지 않고 정정 기록을 덧붙이며, 그 값을 근거로 기록해 둔 답을 다시 계산합니다.
- AI가 제안한 기록은 틀릴 수 있습니다. 2026년 9월 22일 창업팀이 공개 논문을 외부 AI 모델에게 읽혔을 때, AI가 제안한 기록 후보 3건은 모두 원문 위치를 틀리게 적었습니다.
AI의 제안을 원문과 대조하는 검사는 "RAG 구축 방법: 출처를 밝히며 답하는 AI를 만드는 5단계"의 2단계에서 설명합니다. RAG(검색 증강 생성)는 AI가 답을 쓰기 전에 관련 문서를 찾아 근거로 삼게 하는 방식입니다(Lewis 외, 2020).
온톨로지와 지식 그래프는 무엇이 다른가요?
온톨로지는 어떤 종류의 대상과 관계가 있는지 정한 틀이고, 지식 그래프는 그 틀에 따라 실제 사실을 이어 놓은 자료입니다.
자세한 차이는 "온톨로지란? 뜻과 구성 요소, 데이터베이스와의 차이"에서, 지식 그래프의 뜻과 구성은 "지식 그래프란? 뜻과 시소러스·택소노미와의 차이"에서 설명합니다.
온톨로지 구축에는 어떤 도구를 쓰나요?
온톨로지를 OWL 파일로 직접 편집할 때는 스탠퍼드 대학이 만든 무료 오픈 소스(소스 코드가 공개된) 편집 도구 Protégé가 널리 쓰입니다(Stanford Protégé). 기록을 관계형 데이터베이스(자료를 행과 열로 이루어진 표에 저장하는 데이터베이스)에 쌓는 시스템이라면, 표의 칸과 표준 어휘의 개념을 잇는 대응을 따로 적어 두는 방법도 있습니다.
관계형 데이터베이스의 표를 표준 어휘와 잇는 방법은 "온톨로지란? 뜻과 구성 요소, 데이터베이스와의 차이"의 데이터베이스 스키마(자료를 저장할 표와 칸의 구조) 절에서 설명합니다.
만든 온톨로지로 무엇을 답할 수 있나요?
시제품은 기록에서 답을 찾는 조회와, 시료, 설비, 조건이 서로 비교할 수 있는지 따지는 적용 가능성 판단까지 답합니다. 등록된 계산 모형으로 하는 예측은 아직 구현하지 않았습니다.
시제품은 실험마다 시료와 설비, 실험 조건을 함께 기록해 두고 질문의 조건과 맞춰 봅니다. 그래서 질문한 온도가 실험한 온도 범위 안에 든다는 이유만으로 다른 설비에서 나온 결과를 적용하지 않고, 판단에 필요한 정보가 없으면 무엇이 부족한지 함께 보여 줍니다. 보고된 실험이 없는 조건을 물으면 값을 지어내지 않고 "보고된 실험이 없다"고 답합니다.
아모프가 하지 않는 것
아모프는 기록을 짐작으로 채우거나 임의로 바꾸거나 합치지 않습니다. 창업팀이 이를 위해 시제품에 둔 규칙은 다음 네 가지입니다.
- 보고된 값 사이를 짐작해 채우거나, 여러 문헌의 값을 평균 내거나 다수결로 고르지 않습니다.
- 단위를 임의로 바꾸지 않습니다.
- 문장이 비슷하다는 이유로 두 기록을 합치지 않습니다.
- 원문에 없는 실험 날짜를 출판일로 채우지 않습니다.
근거와 한계
이 글의 방법은 아모프 창업팀이 만든 시제품의 설계 기록과 2026년 9월부터 10월까지의 시험 기록에서 가져왔습니다. 시험에 쓴 규격과 성적서는 시험용으로 지어낸 자료였고, 실제 문서로는 오픈 액세스 논문을 읽어 회사 자료와 섞이지 않도록 따로 마련한 시험용 원장에 기록했습니다. 따라서 이 글의 내용은 실제 회사의 업무에 쓰인 결과가 아닙니다.
오픈 액세스 논문은 누구나 인터넷에서 무료로 읽고 내려받을 수 있게 공개된 논문입니다(BOAI, 2002).