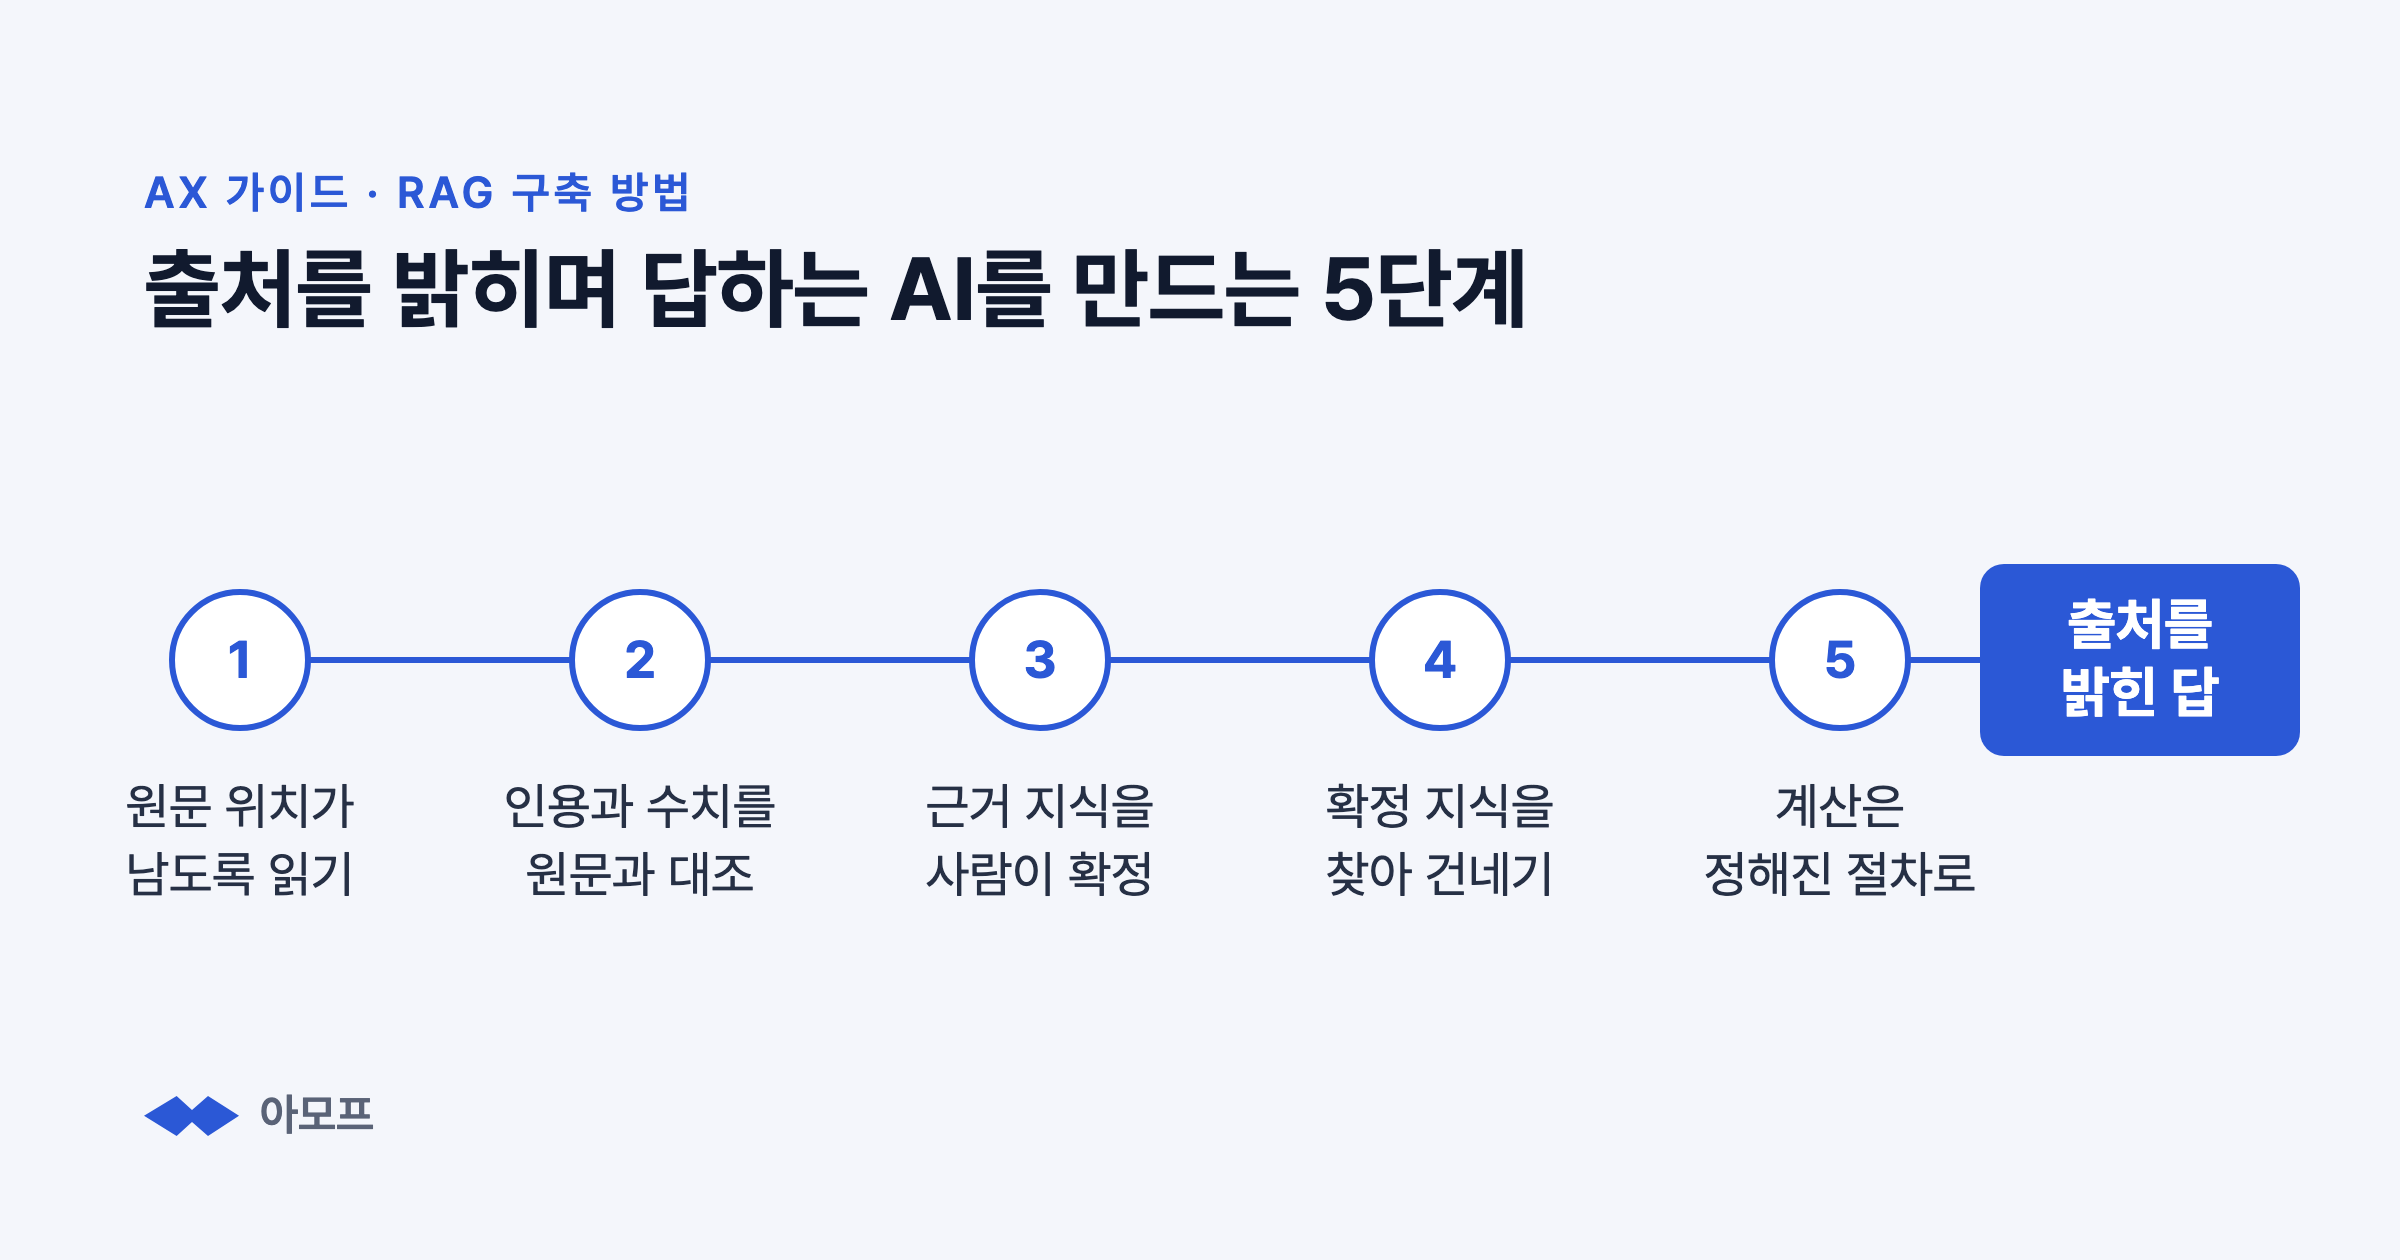
RAG(검색 증강 생성)는 AI가 답을 쓰기 전에 사내 문서 같은 별도의 자료에서 관련 내용을 찾아 근거로 삼게 하는 방식입니다(Lewis 외, 2020). 아모프는 문서를 원문 위치가 남도록 읽고, AI가 뽑은 내용을 원문과 대조하고, 사람이 확인한 기록만 찾아 AI에게 건네는 순서로 RAG를 만듭니다.
이 글의 다섯 단계는 아모프 창업팀이 2026년 9월부터 10월까지 만든 지식 AI 시제품에 적용한 방법입니다. 이 시제품은 한 컴퓨터에서 실행하는 형태이며, 공개 논문과 시험용 문서로 시험했을 뿐 실제 회사의 업무에 쓴 결과가 아닙니다.
1단계: 문서를 원문 위치가 남도록 읽습니다
문서를 조각으로 나눠 읽을 때 조각마다 원문 위치를 함께 저장해야, 나중에 답의 근거를 원문에서 다시 찾아 확인할 수 있습니다. 시제품은 한글 문서(HWPX), 워드 문서(DOCX), PDF, 엑셀 파일(XLSX), CSV, 텍스트 파일과 학술지 XML을 읽고, 조각마다 "1구역 2표 3행 2열"처럼 원문 위치를 붙입니다.
CSV는 표의 칸을 쉼표로 나눠 글자로 적은 파일이고, XML은 글의 각 부분에 태그라는 이름표를 붙여 구조를 표시하는 파일 형식입니다. HWPX는 워드프로세서 한글로 만든 문서를 국가표준 KS X 6101(OWPML)에 따라 XML 형식으로 저장하는 파일 형식입니다(한글과컴퓨터). 학술지 XML(JATS)은 논문의 제목, 절, 문단, 표를 구조째 담는 XML 형식으로, 미국 표준 ANSI/NISO Z39.96으로 정해져 있습니다(NISO).
한글과 워드 문서, 학술지 XML은 표의 칸이나 줄까지 위치를 남길 수 있지만, PDF는 쪽과 그 쪽에서 읽힌 글 조각의 차례까지만 남깁니다.
| 문서 형식 | 원문 위치를 적는 방식(예) |
|---|---|
| 한글 문서(HWPX) | 1구역 2표 3행 2열, 1구역 3문단 |
| 워드(DOCX) | 1표 1행 2열, 2문단 |
| 1쪽 2문단(쪽 안에서 읽힌 글 조각의 차례) | |
| 엑셀(XLSX) | "Sheet1" 시트 5행(시트 이름과 엑셀의 행 번호) |
| CSV | 2행(머리글 줄이 1행) |
| 텍스트 | 3줄 |
| 학술지 XML(JATS) | 2.3절 1문단, 표 3 2행, 표 3 각주 1 |
PDF의 "2문단"은 실제 문단이 아니라 그 쪽에서 읽힌 글 조각의 차례이므로, 원문과 맞춰 볼 때 주의해야 합니다. 엑셀 파일은 XLSX 형식만 받고, CSV 파일은 UTF-8로 저장한 것만 받습니다. UTF-8은 한글과 영문을 비롯한 여러 나라의 글자를 한 가지 규칙으로 저장하는 표준 방식이며, 엑셀에서는 저장할 때 "CSV UTF-8"을 고르면 됩니다. 옛 HWP나 XLS 파일, UTF-8이 아닌 CSV 파일을 올리면 HWPX, XLSX, "CSV UTF-8" 가운데 맞는 형식으로 다시 저장해 올리라는 이유를 보이며 거절합니다.
2단계: 인용과 수치를 원문과 대조합니다
AI가 문서에서 뽑은 기록 후보는 인용이 그 위치의 원문에 글자 그대로 있을 때만 검사를 통과하고, 표에서 읽은 수치는 같은 줄과 같은 열, 같은 실험 조건에 있을 때만 통과합니다. 기록 후보는 AI가 문서에서 읽어 냈지만 아직 사람이 확정하지 않은 기록을 말합니다. 이 검사는 다음 단계에서 사람이 확정하기 전에 돌아가므로, 검사를 통과하지 못한 후보는 확정할 수 없습니다.
이런 대조가 필요한 이유는 출처가 붙은 답에도 출처가 뒷받침하지 않는 문장과 잘못 붙은 인용이 자주 섞이기 때문입니다. 생성형 검색 엔진은 질문에 대한 답을 문장으로 쓰면서 출처를 함께 붙이는 검색 서비스입니다. 2023년에 발표된 한 연구에서 당시 널리 쓰이던 생성형 검색 엔진 네 곳의 답을 사람이 평가했더니, 평균적으로 답의 문장 가운데 51.5%만 인용으로 완전히 뒷받침되었고, 인용 가운데 74.5%만 그 인용이 붙은 문장을 뒷받침했습니다(Liu·Zhang·Liang, 2023).
아모프 창업팀도 같은 문제를 겪었습니다. 2026년 9월 22일 시제품에서 AI가 논문의 13번째 줄에만 있는 수치를 설명에 쓰면서, 근거로는 14번째 줄만 인용한 일이 있었습니다. 그 수치 자체는 논문에 실제로 있는 값이었지만, 기록 후보에 붙은 근거만으로는 되짚을 수 없었습니다. 출처가 붙어 있다는 것만으로는 그 출처가 문장을 뒷받침하는지 알 수 없으므로, 설명에 쓴 수치가 인용한 원문에 실제로 들어 있는지도 따로 확인해야 합니다.
- 적힌 위치가 원문에 실제로 있는지, 인용한 글이 그 위치에 글자 그대로 있는지 확인합니다.
- 뜻이 비슷한 말로 바꾼 문장은 인용으로 보지 않습니다.
- "<10"처럼 상한만 보고된 값은 한 점의 값이 아니라, 상한이 10인 범위로 읽습니다.
- AI가 고쳐 쓴 설명은 원문과 구별해 표시합니다.
3단계: 근거로 쓸 지식을 사람이 확정합니다
AI가 문서에서 읽은 내용은 바로 검색 대상이 되지 않습니다. AI가 뽑은 기록 후보가 검사를 통과한 뒤 담당자가 원문 인용과 위치를 보고 확정해야 지식 원장에 들어가며, 그때부터 다른 대화에서도 찾아 쓰는 근거가 됩니다.
지식 원장은 사람이 확인한 기록만 시간 순서대로 덧붙여 쌓는 데이터베이스입니다. 이미 들어간 기록은 고치거나 지우지 않고, 바뀐 내용은 정정 기록으로 덧붙입니다.
- 채팅창에서 "맞다"고 답하는 것만으로는 아무것도 기록되지 않고, 확정 버튼을 눌러야 기록됩니다.
- 검사를 통과하지 못한 후보에는 확정 버튼이 생기지 않습니다. 검사 방법은 2단계에서 설명했습니다.
- 확정되지 않은 후보와, 더 이상 쓰지 않기로 표시한 철회된 지식은 지식 검색에서 빠집니다.
어떤 종류의 기록을 어떤 출처와 함께 확정할지는 "온톨로지 구축 방법: 기술 문서와 실험 기록을 지식으로 바꾸는 5단계"에 정리했습니다.
4단계: 질문에 맞는 확정 지식을 찾아 AI에게 건넵니다
질문이 들어오면 사람이 확정한 지식 가운데 질문과 관련된 기록을 골라, 출처와 함께 AI의 문맥에 넣습니다. 근거를 몇 개 넣을지는 문서와 질문의 종류마다 따로 정해야 하는 설계 값입니다.
문맥(컨텍스트)은 AI가 답을 쓸 때 함께 받아 읽는 참고 글입니다. 2023년에 공개되어 2024년 학술지 TACL에 실린 연구에서는 필요한 정보가 입력의 처음이나 끝에 있을 때보다 가운데에 있을 때 AI가 더 자주 놓쳤으므로(Liu 외, 2024), 근거를 많이 넣는다고 답이 꼭 좋아지지는 않습니다. 입력의 가운데에 놓인 정보를 놓치는 이 현상은 "컨텍스트 윈도우란? AI가 긴 대화와 긴 문서에서 놓치는 것"에서 자세히 다룹니다.
- 넣지 못한 관련 기록이 있으면 그 사실을 AI에게 알려야, AI가 목록 밖의 기록을 없다고 단정하지 않습니다.
- 맞는 기록이 없으면 이유와 함께 빈 결과를 돌려주고, 비슷해 보인다는 이유로 없는 근거를 만들어 넣지 않습니다.
- 확정되지 않은 자료를 함께 보여 줄 때는 확정된 지식과 구별해 표시합니다.
아모프 창업팀이 2026년 9월 24일에 마친 시험에서는 공개 논문 두 편을 읽어 시험용 지식 원장에 지식을 확정한 뒤, 논문을 올리지 않은 새 대화에서 관련 용어를 물었습니다. 시제품은 확정된 지식을 출처와 함께 다시 찾아 AI에게 건넸고, 이 대화로 지식 원장이 바뀌지는 않았습니다. 이 시험의 확정은 실제 사용자가 한 것이 아니므로, 실제 사용자의 승인으로 기록하지 않았습니다.
5단계: 계산이 필요한 답은 정해진 절차가 씁니다
기준을 충족하는지처럼 계산이 필요한 답은 AI의 문장이 아니라 시제품에 정해 둔 계산 절차가 쓰므로, AI가 쓴 문장이 계산값을 바꿀 수 없습니다. 이런 답에는 근거가 된 값과 문서 이름, 원문 위치가 함께 표시됩니다.
보고된 실험이 없는 조건을 물으면 값을 지어내거나 주변 실험값으로 짐작하지 않고 "보고된 실험이 없다"고 답하며, 단위나 시험법이 달라 비교할 수 없으면 "판정불가"로 답합니다. 판정불가는 "충족"과 "미충족"에 이은 세 번째 답으로, 근거가 부족하거나 단위나 시험법이 달라서 기준을 충족하는지 판단할 수 없을 때 냅니다.
- 값이 "<10"으로만 보고되었는데 기준이 "5 이하"라면, 그 값이 기준을 충족하는지 판단할 수 없으므로 판정불가로 답합니다.
- 시제품은 단위를 임의로 바꾸지 않으므로, 시간 단위 h(시간)와 min(분)이 섞이면 판정불가로 답합니다.
- 답에 필요한 조건이 질문에 빠져 있으면 판정한 것처럼 답하지 않고, 필요한 조건을 되묻습니다.
아모프의 시제품도 RAG인가요?
네. 질문이 들어올 때마다 사람이 확인한 지식을 찾아 AI에게 함께 건네므로 RAG에 속합니다. 다만 문서 조각 전체가 아니라, 사람이 확정한 지식만을 찾는 범위로 삼는다는 점이 다릅니다.
RAG라는 이름을 붙인 연구의 모델은 위키백과를 벡터 색인으로 만들어 두고, 미리 학습시킨 AI 검색 모델로 질문에 맞는 글을 찾아 답을 쓰는 모델에 건넸습니다(Lewis 외, 2020). 색인은 빨리 찾을 수 있도록 미리 정리해 둔 자료입니다. 벡터 색인은 글마다 그 뜻을 숫자 목록인 벡터로 나타내 저장해 두고, 질문의 벡터와 가까운 글을 찾는 데 쓰는 색인입니다.
PDF와 HWP 문서의 표는 어떻게 처리하나요?
HWP 문서는 HWPX로 다시 저장하면 표의 칸마다 위치를 붙여 읽을 수 있습니다. PDF의 표는 행과 열 구조가 사라지기 쉬우므로, 표의 수치는 학술지 XML이나 원래의 엑셀 파일처럼 표 구조가 남은 형식에서 확인하는 편이 안전합니다.
옛 HWP 파일은 내용을 XML처럼 글자로 적지 않고 프로그램 전용 데이터로 저장하는 이진 형식이며(한글과컴퓨터), 시제품은 이 형식을 직접 읽지 않습니다. 같은 논문을 PDF와 학술지 XML로 읽어 비교한 결과는 "AI는 논문 PDF의 표에서 수치를 제대로 읽을 수 있나요?"에 정리했습니다.
같은 문서를 넣으면 AI가 매번 같은 결과를 내나요?
아니요. 2026년 9월 29일 아모프 창업팀이 같은 논문을 같은 외부 모델에게 세 번 읽게 했을 때, 정해 둔 목록 형식으로 읽어 낼 수 있었던 답은 세 번 가운데 한 번뿐이었습니다.
외부 모델은 다른 회사가 인터넷으로 제공하는 AI 모델입니다. 나머지 두 번은 답의 원문이 남지 않아 원인을 확인하지 못했지만, 같은 입력에서도 결과가 실행마다 달랐으므로 AI가 읽은 결과는 기록하기 전에 사람이 원문과 대조해야 합니다.
RAG와 파인튜닝은 무엇이 다른가요?
파인튜닝은 이미 학습된 모델을 특정 작업의 자료로 더 학습시키는 방법이고, RAG는 답할 때마다 모델 밖의 자료를 찾아 모델에게 건네는 방법입니다. 그래서 RAG에서는 문서가 바뀌어도 모델을 다시 학습시키지 않고, 찾는 자료만 바꿔 답의 근거를 바꿀 수 있습니다. 두 방법을 비교한 연구는 "RAG란? 검색 증강 생성의 뜻과 작동 순서, 한계"에서 다룹니다.
사내 문서를 외부 AI로 보내지 않고 RAG를 만들 수 있나요?
문서를 읽고 정해진 형식의 문장에서 수치를 확인하는 일은 외부 AI 없이도 할 수 있지만, 자유로운 질문에 답하려면 회사 안에 둔 서버 컴퓨터에 언어 모델을 설치해야 합니다. 언어 모델은 글을 읽고 쓰도록 학습된 AI 모델이며, 이렇게 문서를 회사 밖으로 보내지 않고 만드는 RAG를 흔히 로컬 RAG라고 부릅니다.
시제품은 실행 환경에서 외부 AI 호출을 허용하고 화면에서 외부 모델을 고른 경우에만 그 모델을 부르며, 고른 뒤의 요청부터 질문과 함께 그 대화에 올린 문서의 글과 확정 지식이 그 모델로 전송됩니다.
회사 안에 설치한 모델로 이 시제품을 시험한 결과는 없습니다.
RAG를 만들 때 하지 않는 것
아모프는 근거를 되짚을 수 없는 답을 줄이기 위해, RAG를 만들 때 다음 다섯 가지를 하지 않습니다.
- 뜻이 비슷한 말로 바꾼 문장을 인용으로 인정하지 않습니다.
- AI가 옮겨 적은 글을 원문인 것처럼 근거로 보여 주지 않습니다.
- 문서 안에 숨은 지시문을 AI가 따르더라도, 파일이나 지식 원장이 바뀌는 길을 열어 두지 않습니다. 문서나 웹 페이지에 지시를 숨겨 AI를 조종하는 공격을 프롬프트 인젝션이라고 하며, 소프트웨어 보안 자료를 공개하는 비영리 재단 OWASP는 대형 언어 모델(LLM) 애플리케이션의 10대 위험 2025년판에서 이를 첫째 위험으로 꼽았습니다(OWASP, 2025).
- 모델 호출이 실패하면 다른 모델의 답으로 바꾸지 않고, 실패했다고 알립니다.
- AI가 읽어 내지 못한 표의 줄을 조용히 빠뜨리지 않고, 어느 줄이 빠졌는지 알립니다.
이 글의 근거와 한계
이 글의 방법과 날짜가 붙은 사례는 아모프 창업팀이 2026년 9월부터 10월까지 시제품을 만들고 시험한 기록에서 가져왔으며, 실제 회사의 업무에 쓴 결과가 아닙니다. 시험에는 공개 논문과 시험용으로 만든 문서를 썼습니다. PDF의 "문단"은 추출한 글 조각의 차례여서 실제 문단과 다를 수 있습니다. 외부 연구의 수치는 각 문단에 밝힌 논문에서 가져왔습니다.