온톨로지(ontology)는 한 분야에서 쓰는 개념과 개념 사이의 관계를 컴퓨터가 읽을 수 있도록 명시적으로 정의해 둔 지식 구조입니다. 예를 들어 "실험에는 시료를 쓰고, 실험에서 관측값이 나온다"는 관계를 정해 두면, 문서마다 따로 적힌 수치도 같은 틀에 모아 비교할 수 있습니다.
여기서 시료는 실험에 쓰는 재료의 견본이고, 관측값은 실험에서 재거나 보고한 값이며, 아래에서는 관측값 하나를 담는 기록을 줄여서 관측이라고 부릅니다. 이 글은 온톨로지의 뜻과 말의 유래, 구성 요소를 정리하고, 온톨로지가 지식 그래프(실제 대상과 사실을 이어 놓은 자료)나 데이터베이스 스키마(자료를 저장할 표와 칸의 구조)와 무엇이 다른지 설명합니다. 온톨로지를 만드는 순서는 "온톨로지 구축 방법: 기술 문서와 실험 기록을 지식으로 바꾸는 5단계"에서 따로 다룹니다.
온톨로지와 지식 그래프는 무엇이 다른가요?
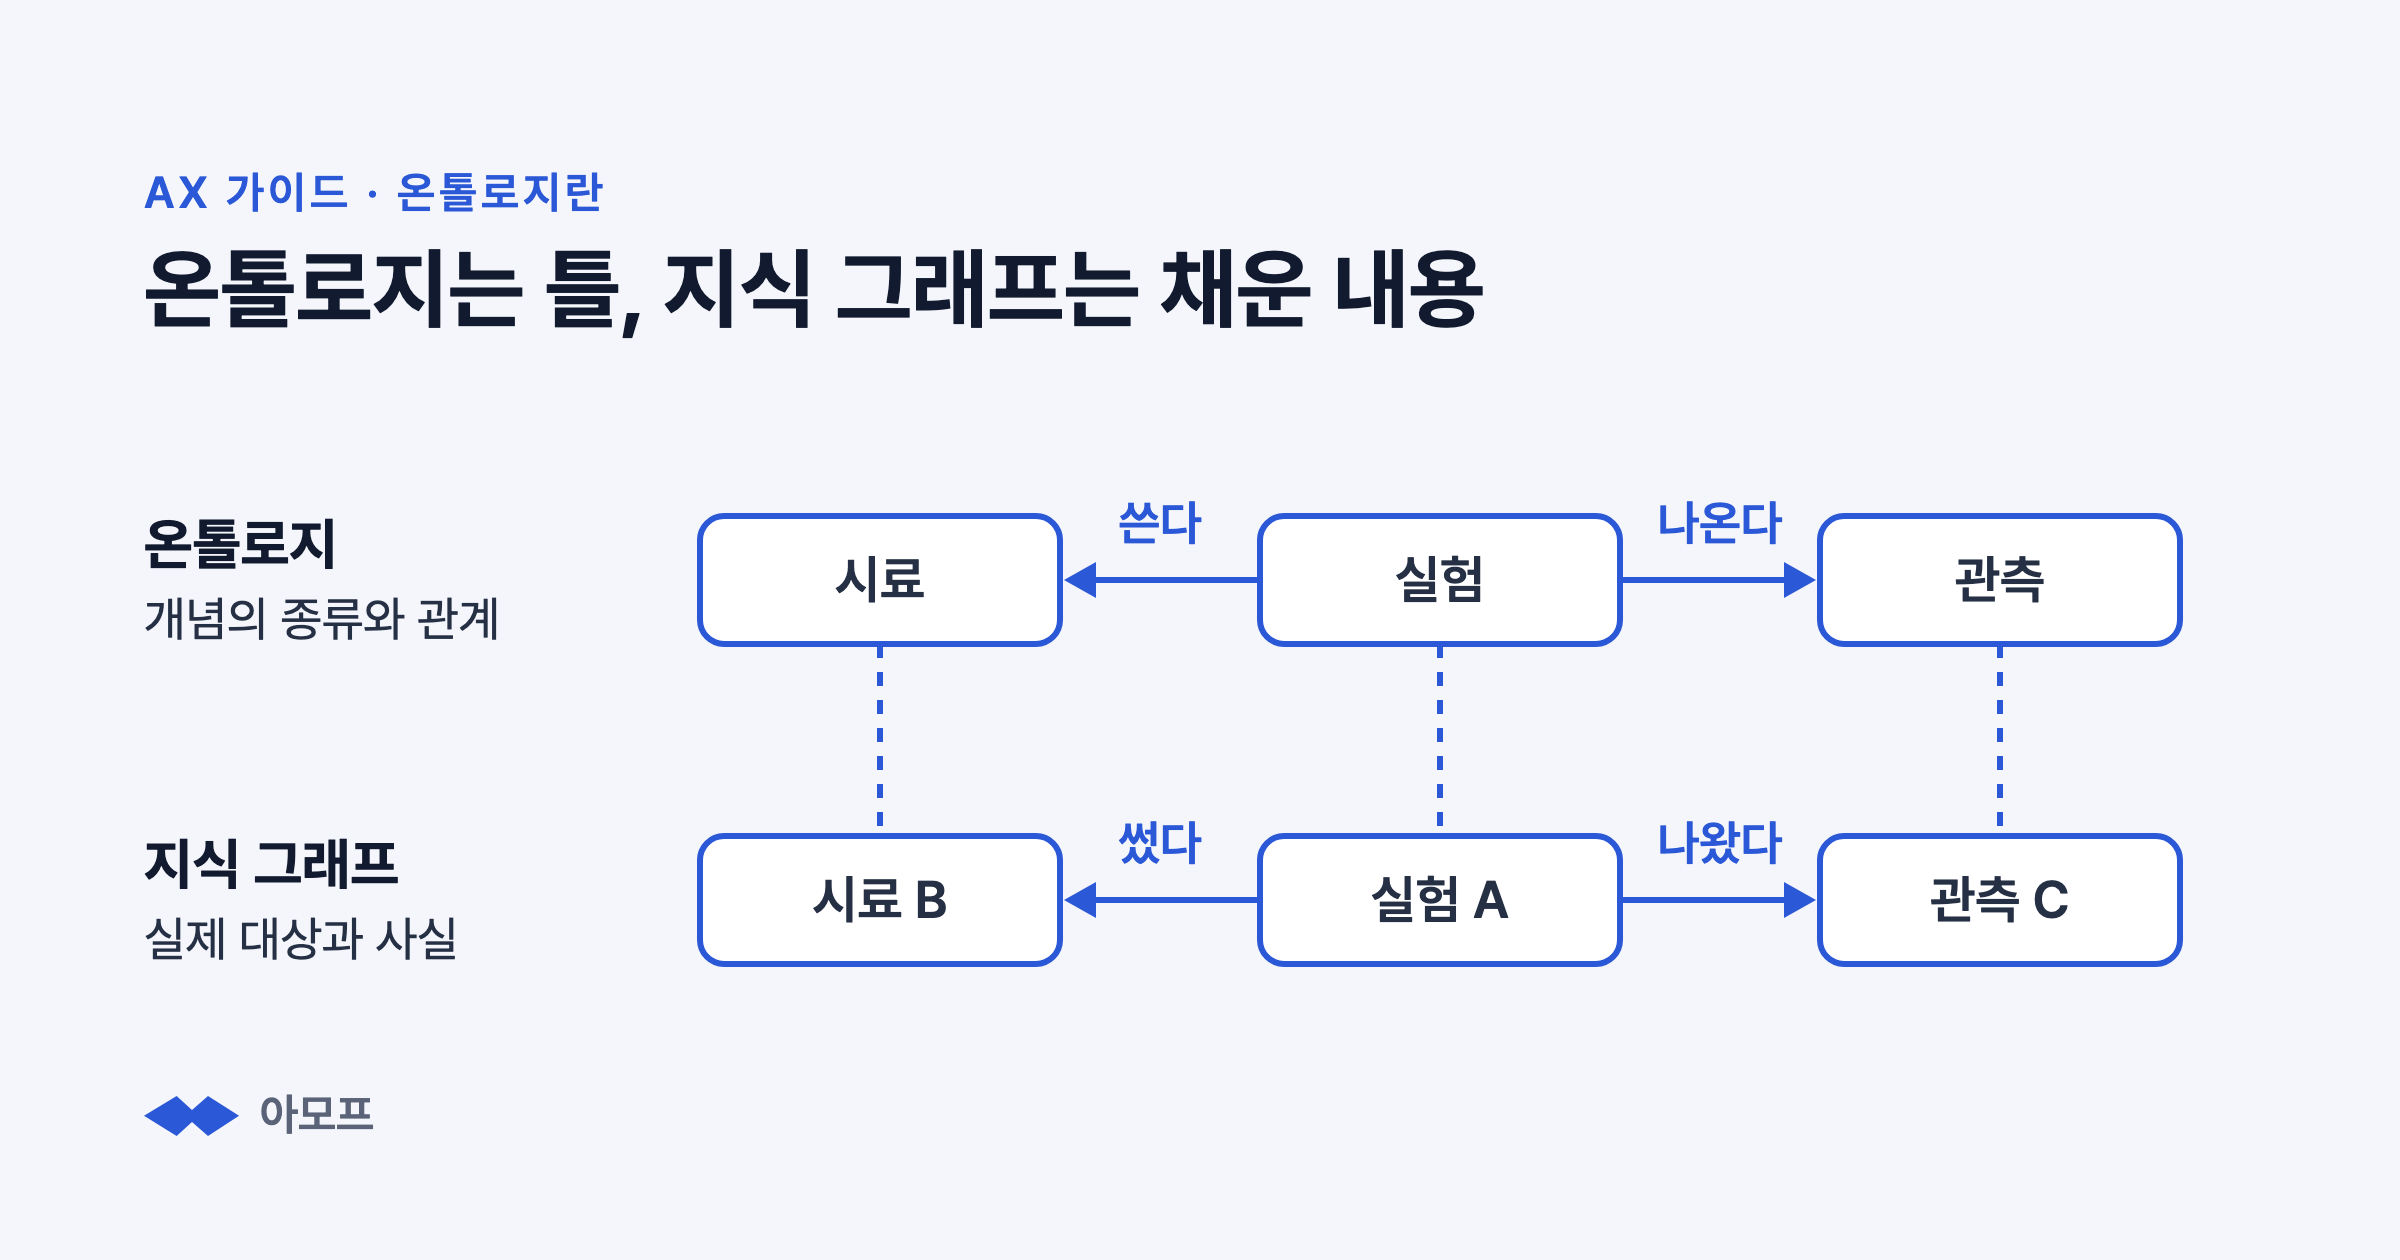
온톨로지는 어떤 종류의 대상과 관계가 있는지 정한 틀이고, 지식 그래프는 그 틀에 따라 실제 대상과 사실을 이어서 쌓은 자료입니다.
연구자 18명이 학술지 ACM Computing Surveys에 실은 지식 그래프 개론 논문은, 지식 그래프를 실제 세계의 지식을 모으고 전하기 위한 데이터의 그래프로 정의합니다. 이 그래프에서 점은 관심 있는 대상을, 점을 잇는 선은 대상 사이의 관계를 나타내고, 온톨로지 같은 지식 표현 방식은 점과 선에 붙은 용어의 뜻을 정의하는 데 쓰일 수 있다고 설명합니다(Hogan 외, 2021).
아모프 창업팀이 만든 지식 AI 시제품에서는 온톨로지가 시료, 실험, 관측이라는 기록의 종류와 그 관계를 정하고, 지식 그래프는 사람이 확인한 기록을 그 틀에 따라 이어서 보여 줍니다. 아직 확인되지 않은 후보는 "확인 대기"로 따로 표시해 확정된 지식과 섞이지 않게 합니다.
정리하면 온톨로지는 틀이고, 지식 그래프는 그 틀을 채운 내용입니다. 두 가지를 나란히 놓으면 다음과 같습니다.
| 구분 | 온톨로지 | 지식 그래프 |
|---|---|---|
| 담는 것 | 개념의 종류와 관계의 규칙 | 실제 대상과 사실의 연결 |
| 예 | "실험은 시료를 쓴다", "실험에서 관측이 나온다" | "실험 A는 시료 B를 썼다", "실험 A에서 관측 C가 나왔다" |
| 바뀌는 때 | 기록의 틀을 고칠 때 | 문서와 기록이 늘 때마다 |
다만 두 말의 경계가 늘 뚜렷하지는 않습니다. 앞의 논문은 지식 그래프가 "모든 수도는 도시다"처럼 여러 대상에 한꺼번에 해당하는 지식까지 담으려면 온톨로지나 규칙 같은 표현 방식이 필요하다고 설명합니다. 그래서 실제 지식 그래프에는 개별 사실과 함께 온톨로지가 들어 있기도 합니다(Hogan 외, 2021).
지식 그래프가 무엇으로 이루어지고 시소러스나 택소노미와 어떻게 다른지는 "지식 그래프란? 뜻과 시소러스·택소노미와의 차이"에서 다룹니다.
온톨로지라는 말은 어디에서 왔나요?
온톨로지는 철학에서 빌려 온 말입니다. 철학에서 온톨로지(존재론)는 존재하는 것에 대한 체계적인 설명을 뜻하며, 컴퓨터 과학에서는 한 분야에 무엇이 있고 서로 어떤 관계인지를 분명하게 적어 둔 명세라는 뜻으로 씁니다(Gruber, 1993).
스탠퍼드 대학의 그루버는 1993년 논문에서 온톨로지를 "개념화의 명시적 명세"로 정의했습니다. 개념화는 관심 있는 분야에 있다고 보는 대상과 개념, 그리고 그 사이의 관계를 단순하게 정리한 세계의 모습이고, 명세는 그것을 여러 사람과 프로그램이 같은 뜻으로 쓸 수 있게 분명하게 적어 둔 설명입니다(Gruber, 1993).
웹 표준을 만드는 국제 비영리 단체 W3C도 온톨로지를 형식을 갖춘 용어의 어휘라고 설명합니다. 이 어휘는 흔히 한 분야를 다루고 한 사용자 집단이 함께 쓰며, 각 용어의 뜻은 같은 온톨로지 안의 다른 용어와 어떤 관계인지를 적어서 정합니다(W3C OWL 2 개요, 2012).
온톨로지는 무엇으로 이루어지나요?
온톨로지는 개념의 종류를 나타내는 클래스, 클래스가 가진 특징을 적는 속성, 속성이 가질 수 있는 값의 종류나 개수를 정하는 제약으로 이루어지며, 개념 사이의 관계도 이 안에서 정의합니다. 여기에 클래스에 속하는 실제 사례인 인스턴스를 더하면 지식 베이스가 됩니다(Noy·McGuinness, 2001).
실험 기록을 다루는 온톨로지를 예로 들면, 각 요소는 다음과 같습니다.
- 클래스는 시료, 실험, 관측 같은 기록의 종류입니다.
- 속성은 관측의 값과 단위, 시험법, 측정한 값인지 계산한 값인지를 적는 산출 방식 같은 칸입니다.
- 관계는 "실험은 시료를 쓴다", "실험에서 관측이 나온다"처럼 기록의 종류 사이를 잇습니다.
- 제약의 예로, 산출 방식 칸에는 "측정", "계산", "미상" 가운데 하나만 적게 할 수 있습니다.
- 인스턴스는 사람이 확인해 확정한 기록 하나하나입니다.
온톨로지와 데이터베이스 스키마는 무엇이 다른가요?
데이터베이스 스키마는 자료를 저장할 표와 칸의 구조를 정하고, 온톨로지는 그 자료가 무엇을 뜻하며 서로 어떤 관계인지를 정합니다.
온톨로지를 적는 W3C의 표준 언어인 OWL의 입문서는, 온톨로지의 용어 정의는 데이터베이스 스키마와, 개별 사실은 데이터베이스의 내용과 비슷하게 볼 수 있지만 둘이 전제하는 바는 다르다고 설명합니다. 데이터베이스는 보통 기록에 없는 사실을 거짓으로 보지만, OWL 문서에서는 적혀 있지 않은 사실도 참일 수 있다고 봅니다. 그러면서도 기술적으로는 많은 온톨로지 중심 시스템에서 데이터베이스가 충분히 쓸 만한 바탕이 된다고 덧붙입니다(W3C OWL 2 입문서, 2012).
그래서 기록은 데이터베이스의 표에 저장하고, 각 칸이 표준 어휘의 어떤 개념에 해당하는지를 따로 적어 두는 방식도 쓰입니다. 표준 어휘는 표준 단체나 비영리 단체가 개념과 관계에 이름을 붙여 공개한 목록입니다. 예를 들어 관측과 센서를 기술하려고 W3C와 지리 공간 정보 표준 단체 OGC가 함께 만든 SOSA/SSN 어휘에는 관측(sosa:Observation)이라는 개념이 있습니다(W3C·OGC, 2017).
RDF는 사실 하나를 주어, 술어, 목적어의 세 부분으로 적는 W3C의 데이터 형식입니다. W3C는 관계형 데이터베이스(자료를 행과 열로 이루어진 표에 저장하는 데이터베이스)의 내용을 RDF로 옮기는 규칙을 적는 언어 R2RML을 2012년에 권고안(W3C가 표준으로 확정한 문서)으로 발표했습니다(W3C R2RML, 2012).
AI를 쓸 때 온톨로지가 왜 필요한가요?
AI가 문서에서 읽은 값이 어느 시료, 어느 실험, 어떤 조건의 값인지 온톨로지라는 정해진 틀에 담겨 있어야, AI가 조건이 다른 값을 섞지 않고 답할 수 있기 때문입니다.
OWL 입문서도 한 분야를 이렇게 정확하게 기술해 두면 사람 사이의 오해를 막고, 소프트웨어가 한결같고 예측할 수 있게 동작하며 다른 소프트웨어와도 잘 연동되게 한다고 설명합니다(W3C OWL 2 입문서, 2012).
아모프 창업팀이 2026년 9월 24일 논문 한 편을 PDF로 읽었을 때는 표의 값과 열의 머리글이 서로 떨어져 읽혀, 글만 보고는 어느 값이 어느 열의 값인지 확실히 알 수 없었습니다. 자세한 비교는 "AI는 논문 PDF의 표에서 수치를 제대로 읽을 수 있나요?"에 정리했습니다. 값과 그 값의 조건을 잇는 틀이 없으면 AI도 조건이 다른 값을 섞기 쉬우므로, 실험마다 시료와 설비, 실험 조건을 함께 기록해 두고 질문의 조건과 맞춰 봐야 합니다. 그래야 질문한 온도가 실험한 온도 범위 안에 든다는 이유만으로 다른 설비에서 나온 결과를 적용하지 않고, 판단에 필요한 정보가 없을 때 무엇이 부족한지도 알 수 있습니다.
팔란티어 온톨로지도 같은 뜻인가요?
낱말은 같지만 가리키는 범위가 다릅니다. 팔란티어(Palantir)의 문서는 자사 플랫폼 Foundry의 온톨로지를, 플랫폼에 통합된 데이터셋(자료 묶음)과 모델 위에 놓여 이들을 실제 세계의 대상과 이어 주는 조직의 "운영 레이어"라고 설명합니다. 또 이 온톨로지가 오브젝트와 속성과 링크 같은 의미 요소에 더해, 액션과 함수 같은 동작 요소까지 담는다고 적습니다(Palantir 문서).
팔란티어 온톨로지가 OWL로 적는 전통적인 온톨로지와 무엇이 다른지는 "팔란티어 온톨로지는 일반 온톨로지와 무엇이 다른가요?"에서 자세히 다룹니다.
온톨로지를 만드는 순서
아모프는 답할 질문 정하기, 기록의 종류 나누기, 값마다 출처 적기, 표준 어휘에 대응시키기, 사람이 확인한 것만 남기기의 다섯 단계로 온톨로지를 만듭니다. 단계마다 무엇을 하는지는 "온톨로지 구축 방법: 기술 문서와 실험 기록을 지식으로 바꾸는 5단계"에 정리했습니다.
온톨로지와 자주 혼동하는 것
온톨로지와 헷갈리기 쉬운 것은 이름이 같은 철학의 존재론과 블록체인 프로젝트 "온톨로지(Ontology)", 그리고 지식 그래프의 한 예인 "구글 지식 그래프"입니다.
- 철학의 존재론은 온톨로지라는 말의 출처이지만, 이 글의 온톨로지는 컴퓨터가 읽는 지식 구조를 뜻합니다.
- 블록체인 프로젝트 "온톨로지(Ontology)"와 그 프로젝트의 암호화폐 ONT는 이름만 같을 뿐, 이 글의 온톨로지와는 관계가 없습니다(Ontology).
- "구글 지식 그래프"는 지식 그래프의 한 예입니다. 구글에서 사람이나 장소, 조직을 검색하면 나오는 정보 상자인 지식 패널은 이 지식 그래프에 있는 대상에 대해 표시됩니다(Google 고객센터).
이 글의 근거
온톨로지의 정의와 말의 유래는 Gruber(1993)와 W3C의 OWL 2 문서(2012)를, 구성 요소는 Noy·McGuinness(2001)를, 지식 그래프의 정의는 Hogan 외(2021)를 따랐습니다. 시제품에 관한 내용은 아모프 창업팀이 2026년 9월부터 10월까지 만든 지식 AI 시제품의 설계 기록에서 가져왔고, 2026년 9월 24일의 관찰은 창업팀이 공개 논문 한 편을 PDF와 학술지 XML로 각각 읽어 직접 비교한 것입니다. 시제품은 한 컴퓨터에서 실행되며, 실제 회사의 업무에 쓴 결과가 아닙니다.