꼭 그렇지는 않습니다. 아모프 창업팀이 2026년 9월 24일 같은 논문 한 편을 PDF와 학술지 XML(JATS)로 각각 읽어 보니, PDF에서는 표의 한 줄이 숫자만 이어진 글 한 줄로 바뀌었고 XML에서는 표 11개가 행과 열 구조 그대로 읽혔습니다.
XML은 글의 각 부분에 태그라는 이름표를 붙여 구조를 표시하는 파일 형식이며, 학술지 XML(JATS)은 논문의 제목, 절, 문단, 표를 구조째 담는 XML 형식으로 미국 표준 ANSI/NISO Z39.96으로 정해져 있습니다(NISO). 이 비교는 아모프 창업팀이 논문 한 편을 PDF와 학술지 XML로 읽고 PDF 표 찾기 도구 하나를 시험한 결과여서, 모든 PDF와 모든 논문 분석 AI에 그대로 적용되지는 않습니다.
PDF 논문의 표는 왜 구조가 깨지나요?
PDF는 쪽마다 글자와 선을 어느 자리에 그릴지 적어 두는 형식이어서, 표의 행과 열을 구조 정보로 따로 표시하지 않은 PDF에서는 읽는 도구가 글자의 위치나 선을 보고 행과 열을 짐작해야 하기 때문입니다.
PDF 표준은 쪽의 내용을 "쪽에 그릴 그래픽 요소를 설명하는 명령의 연속"으로 나타내도록 정하고, 표를 Table, TR(행), TH(머리 칸), TD(데이터 칸) 같은 구조 요소로 표시하는 방법을 따로 정해 두었습니다. 다만 이런 구조 정보를 넣을지는 PDF를 만드는 프로그램이 정하며, 표준 문서도 머리글과 행, 열의 관계는 보통 읽는 프로그램이 짐작해서 정한다고 적고 있습니다(ISO 32000-1, 2008).
아모프 창업팀이 2026년 9월 24일 그 논문의 PDF를 누구나 내려받아 쓸 수 있는 공개 파이썬 라이브러리 pypdf로 쪽마다 읽어 줄 단위로 나눴을 때, PDF 전체가 글 조각 1,195개로 나뉘었습니다. 파이썬 라이브러리는 프로그래밍 언어 파이썬으로 만든 프로그램이 가져다 쓰는 코드 묶음입니다. 글 조각은 PDF에서 뽑은 글을 나눈 한 단위이며, 이 비교에서는 쪽마다 뽑은 글의 한 줄을 글 조각 하나로 셌습니다. 표의 한 줄은 숫자만 이어진 글 조각 하나가 되었고, 열의 머리글은 다른 글 조각에 들어갔습니다.
같은 날 아모프 창업팀이 PDF를 다루는 다른 공개 파이썬 라이브러리 PyMuPDF 1.27.2의 표 찾기 기능을 기본 설정으로 실행했더니 표를 하나도 찾지 못했고, 글자의 위치로 행과 열을 짐작하는 설정으로 바꾸자 본문 전체를 표 하나로 인식했습니다. 이 기능의 기본 설정은 쪽에 그려진 선과 도형으로 표의 칸 경계를 찾고, 다른 설정은 글자의 위치로 가상의 행과 열 경계를 만듭니다(Artifex의 PyMuPDF 문서). 흔히 "PDF 표 추출"이라고 부르는 이 작업은, 같은 도구에서도 설정에 따라 결과가 이렇게 달랐습니다.
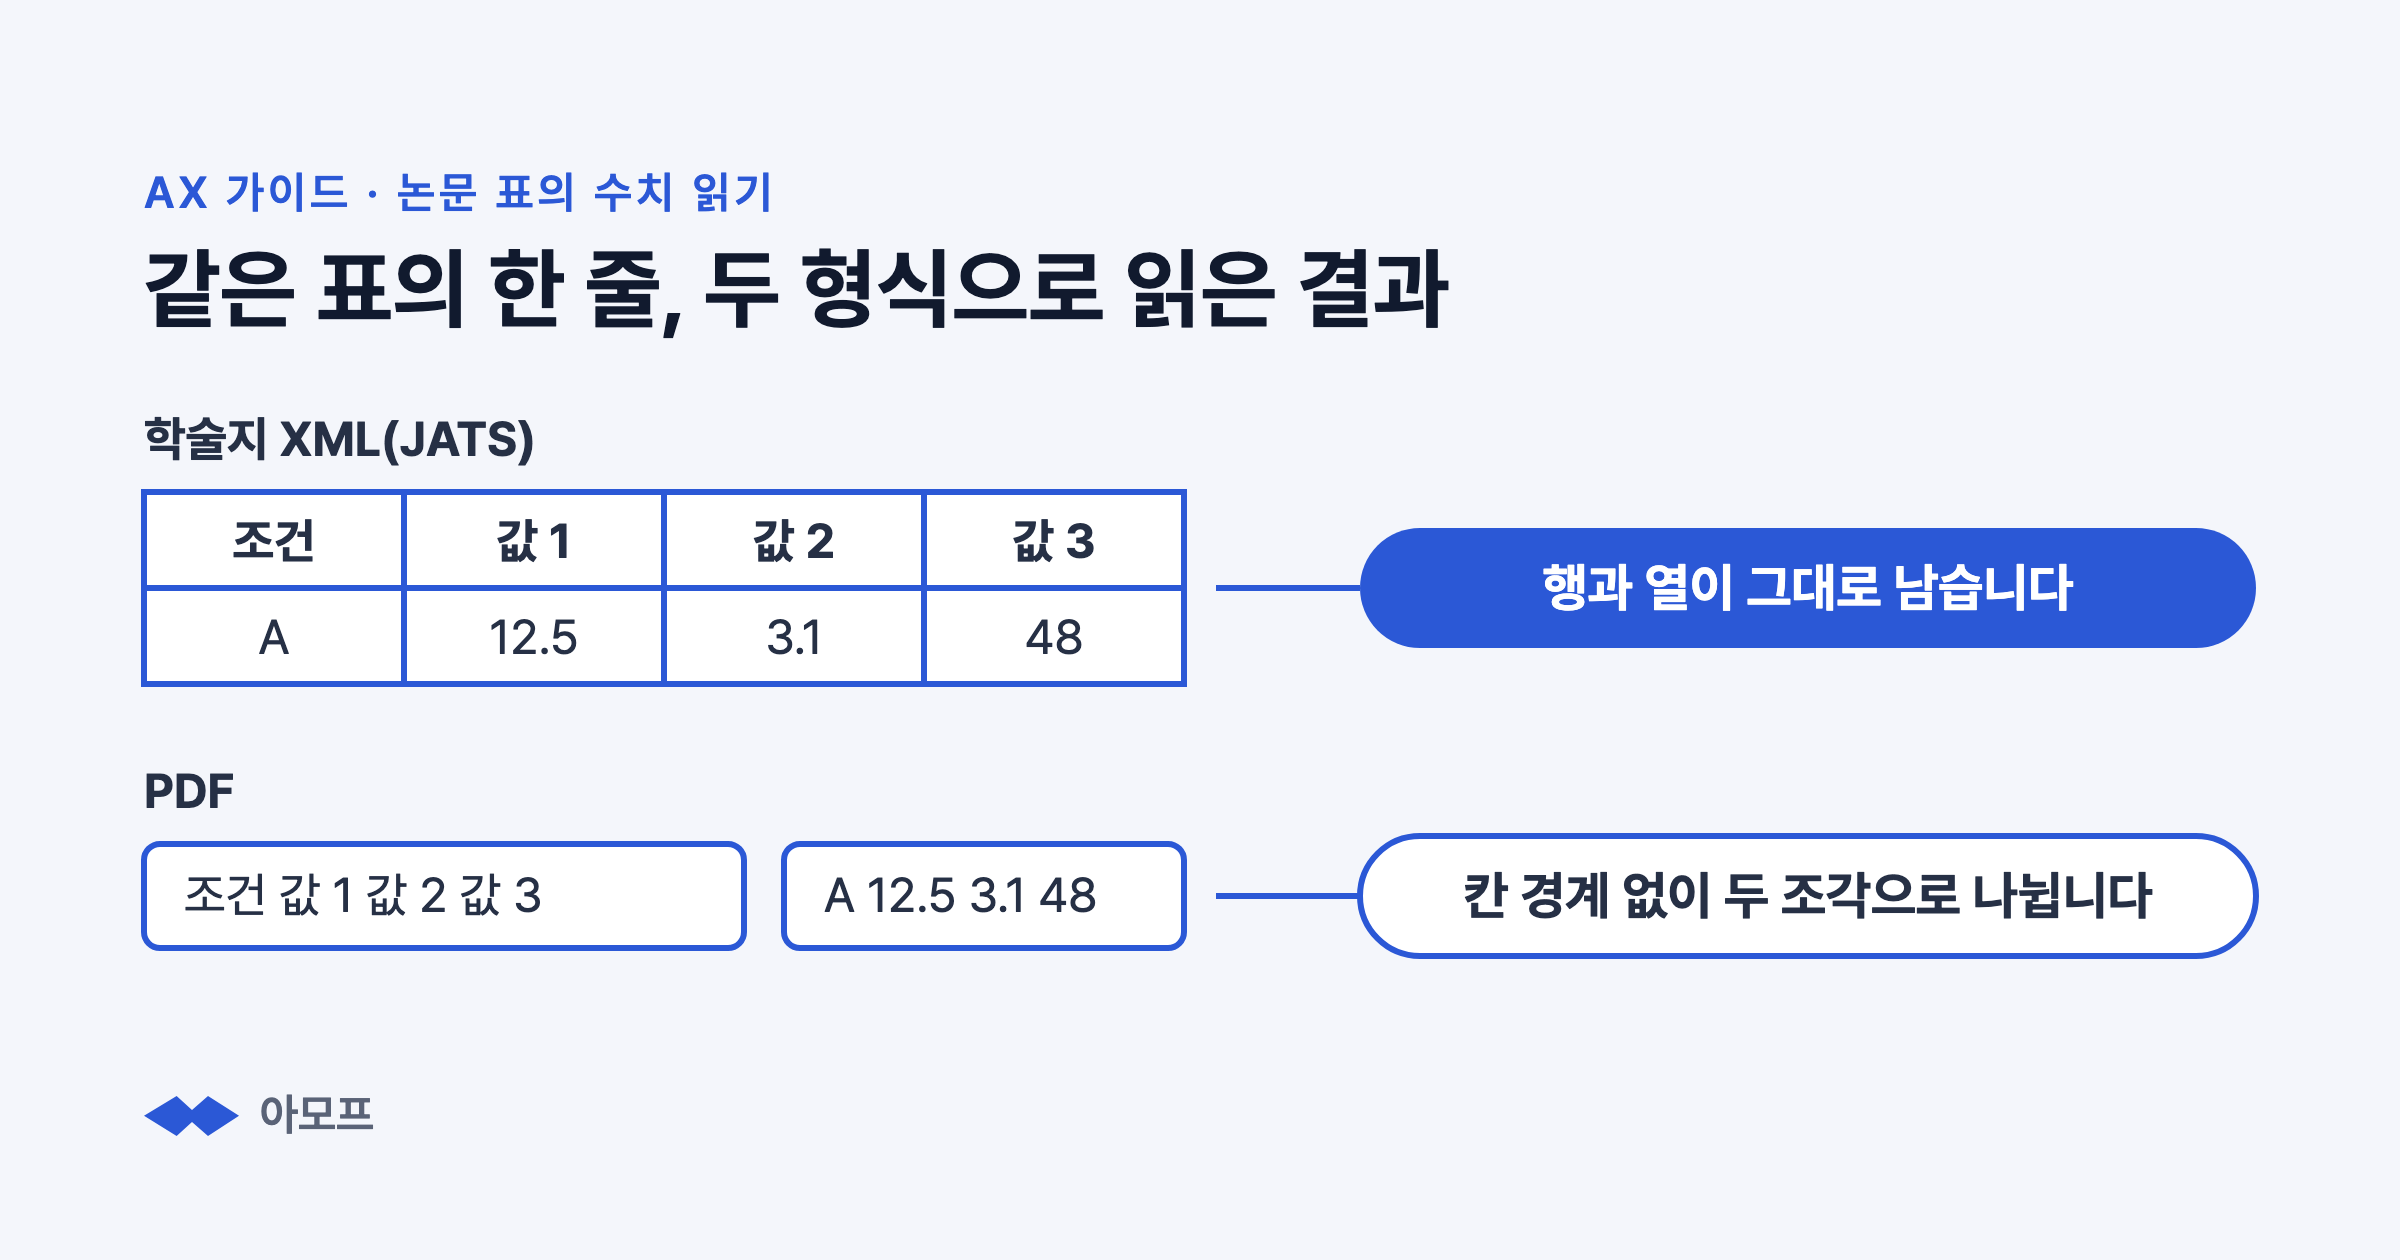
위 그림의 예로 보면, 머리글이 "조건 | 값 1 | 값 2 | 값 3"이고 한 줄이 "A | 12.5 | 3.1 | 48"인 표가 학술지 XML에서는 행과 열이 그대로 남습니다. PDF에서는 머리글이 "조건 값 1 값 2 값 3"이라는 글 조각 하나가 되고 그 줄은 "A 12.5 3.1 48"이라는 다른 글 조각이 되어, 칸 경계 없이 두 조각으로 나뉩니다. 머리글의 낱말 수와 값의 수도 맞지 않으므로, 글만 보고는 12.5가 어느 열의 값인지 확실히 알 수 없습니다.
학술지 XML(JATS)로 읽으면 무엇이 달라지나요?
학술지 XML에는 표의 행과 열, 제목, 각주가 구조로 들어 있어서, 같은 논문을 학술지 XML로 읽었을 때 표 11개가 모두 행과 열로 읽혔습니다.
JATS의 표 요소는 표의 행과 열, 제목, 각주를 한데 묶어 담고, 행 요소는 한 줄에 속한 머리 칸과 데이터 칸을 모두 담습니다(미국 국립의학도서관 JATS 1.4 태그 설명서). 아모프 창업팀은 2026년 9월 24일 그 논문의 학술지 XML에서 표 11개가 모두 행과 열로 읽히는 것을 확인했습니다. 다만 학술지 XML로 읽을 때도 다음 세 가지는 따로 다뤄야 합니다.
- 여러 칸을 합친 칸이 있으면 줄마다 칸 수가 달라지므로, 합친 칸을 어떻게 펼칠지 먼저 정해야 합니다.
- 값 뒤에 붙은 각주 표시는 값의 숫자와 섞이기 쉽습니다. 예를 들어 12.5 뒤에 각주 표시 2가 붙어 있으면, 글자만 이어 붙인 결과는 12.52가 됩니다.
- 표의 제목과 머리 줄, 각주에도 단위와 조건이 적혀 있으므로, 본문 줄과 따로 읽어 위치를 남겨야 합니다.
같은 논문 한 편을 두 형식으로 읽어 보니, PDF에서는 표가 줄 단위의 글로만 남았고 학술지 XML에서는 표 11개의 행과 열이 그대로 남았습니다(아모프 창업팀, 2026년 9월 24일).
| 항목 | 학술지 XML(JATS) | |
|---|---|---|
| 읽은 도구 | pypdf로 쪽마다 글 추출 | JATS의 표 요소를 행과 열로 읽음 |
| 나뉜 단위 | 글 조각 1,195개(쪽마다 줄 단위) | 절, 문단, 표의 줄 |
| 표의 한 줄 | 숫자만 이어진 글 조각 하나 | 칸이 나뉜 한 줄 |
| 열의 머리글 | 값과 다른 글 조각 | 각 열의 이름으로 남음 |
| 표의 구조 | 줄 단위 글로만 남음 | 표 11개가 행과 열 그대로 남음 |
| 표 찾기 도구 | PyMuPDF 1.27.2 기본 설정에서 표 0개 | 쓰지 않음(구조가 이미 있음) |
학술지 XML은 어디에서 구하나요?
누구나 무료로 읽을 수 있게 공개된 오픈 액세스 논문 가운데 생명과학이나 의학 분야의 논문이라면, 논문 저장소 PubMed Central(PMC)에서 학술지 XML을 받을 수 있는지 먼저 확인해 보세요. PMC는 재사용을 허락한 논문의 본문 전체를 NISO JATS 형식의 XML로 내려받을 수 있게 제공합니다(NCBI PMC). 다른 분야의 논문은 출판사 누리집에서 XML 파일을 함께 내려받을 수 있는지 확인해 보세요.
PMC는 미국 국립보건원 산하 국립의학도서관이 운영하는, 생명과학과 의학 분야 학술지 논문의 본문 전체를 무료로 모아 둔 저장소입니다(NCBI PMC). 다만 PMC에 있는 논문이라도 모두 재사용할 수 있는 것은 아니고 이용 조건이 논문마다 다르므로, 논문에 적힌 이용 허락을 먼저 확인해야 합니다(NCBI PMC).
CC BY 4.0은 출처를 밝히고 이용 허락 문서의 링크를 달고 바꾼 점을 표시하면, 상업적 목적을 포함해 자료를 복제하고 배포하고 고쳐 쓸 수 있게 한 이용 허락입니다(Creative Commons). 아모프 창업팀이 비교에 쓴 논문도 이 조건으로 공개된 논문입니다.
AI가 읽은 수치가 맞는지 어떻게 확인하나요?
AI가 제안한 수치가 인용한 표의 같은 줄, 같은 열에 실제로 있는지, 그리고 단위와 실험 조건이 맞는지를 다시 대조해야 합니다. 인용문을 글자 그대로 대조하는 것만으로는 부족한데, 표의 한 줄을 인용하면 그 줄에 있는 다른 열의 값도 모두 인용 안에 들어 있기 때문입니다.
- 인용한 줄이 머리 줄이 아니라 표의 본문 줄인지, 값이 놓인 열의 머리글이 기록할 측정 항목과 맞는지 확인합니다.
- "<10"처럼 적힌 값은 한 점의 값이 아니라 상한으로 읽습니다.
- 단위가 표 제목이나 열의 머리글에 있는지, 그 줄이 가리키는 실험 조건이 기록할 실험과 같은지 확인합니다.
- 논문의 각주가 다른 값을 빼서 구했다고 밝힌 열의 값은 측정값이 아니라 계산값입니다.
인용을 원문과 대조하는 기준은 "RAG 구축 방법: 출처를 밝히며 답하는 AI를 만드는 5단계"의 2단계에서 설명합니다.
XML이 없는 논문은 어떻게 하나요?
아모프는 XML이 없는 논문의 표 수치를 사람이 PDF의 표를 직접 보고 확인한 뒤에 기록하도록 권합니다. 앞에서 본 것처럼 PDF에서는 표의 구조가 사라지기 쉽고, 표 찾기 도구도 설정에 따라 표를 하나도 찾지 못하거나 본문 전체를 표 하나로 읽었기 때문입니다.
논문과 함께 공개된 엑셀이나 CSV 같은 데이터 파일이 있다면, 표 구조가 남아 있는 그 파일에서 수치를 확인하는 편이 안전합니다. 본문 문장에 든 수치는 표보다 뜻이 모호한 경우가 많습니다. 한 문장에 같은 단위의 수가 여럿 있거나 "about"이나 "more than"처럼 어림값이나 한쪽 범위를 나타내는 말이 붙은 수는, 어느 값이 무엇을 가리키는지 글만으로 가리기 어려우므로 사람이 표에서 확인하는 편이 안전합니다.
엑셀로 받은 연구 데이터는 무엇을 조심해야 하나요?
수식 칸에 계산 결과가 저장되어 있지 않을 수 있으므로, 값을 읽기 전에 수식 칸을 따로 확인해야 합니다.
2026년 9월 아모프 창업팀이 공개 연구 데이터셋 하나의 엑셀 통합 문서를 읽어 보니, 수식 칸 2,375개가 모두 계산 결과 없이 저장되어 있었습니다. 데이터셋은 연구에서 모은 자료를 파일로 묶은 것이고, 통합 문서는 시트 여러 장을 담은 엑셀 파일 하나를 말합니다. 저장된 값만 읽는 방식이었다면 이 칸들은 통째로 빈칸이 되었을 것입니다.
이런 칸을 만나면 수식을 다시 계산할지, 수식 글을 그대로 근거로 남길지를 값을 읽기 전에 정해야 합니다. 이 결과는 데이터셋 하나에서 본 것이어서, 연구용 엑셀 파일이 대부분 이렇다는 뜻은 아닙니다.
그럼 무엇부터 해야 하나요?
먼저 갖고 있는 논문을 학술지 XML을 구할 수 있는 것과 PDF만 있는 것으로 나누고, PDF만 있는 논문의 표 수치는 사람이 확인하는 단계를 따로 두세요. 연구소의 논문과 실험 기록을 근거와 함께 쌓으려면, 기록의 종류와 출처를 정하는 "온톨로지 구축 방법: 기술 문서와 실험 기록을 지식으로 바꾸는 5단계"와 출처를 밝히며 답하는 "RAG 구축 방법: 출처를 밝히며 답하는 AI를 만드는 5단계"를 함께 보세요.
조사 방법과 한계
- 비교에 쓴 논문은 CC BY 4.0으로 공개된 오픈 액세스 논문 한 편입니다.
- PDF의 글은 pypdf로 뽑았고, PDF의 표 찾기는 PyMuPDF 1.27.2의 기본 설정과 글자 위치 설정으로 시험했습니다.
- 실제 외부 AI 모델로 같은 논문을 읽힌 결과는 실행할 때마다 달랐습니다.
- 다른 도구나 설정, 다른 출판사의 PDF에서는 결과가 다를 수 있습니다.