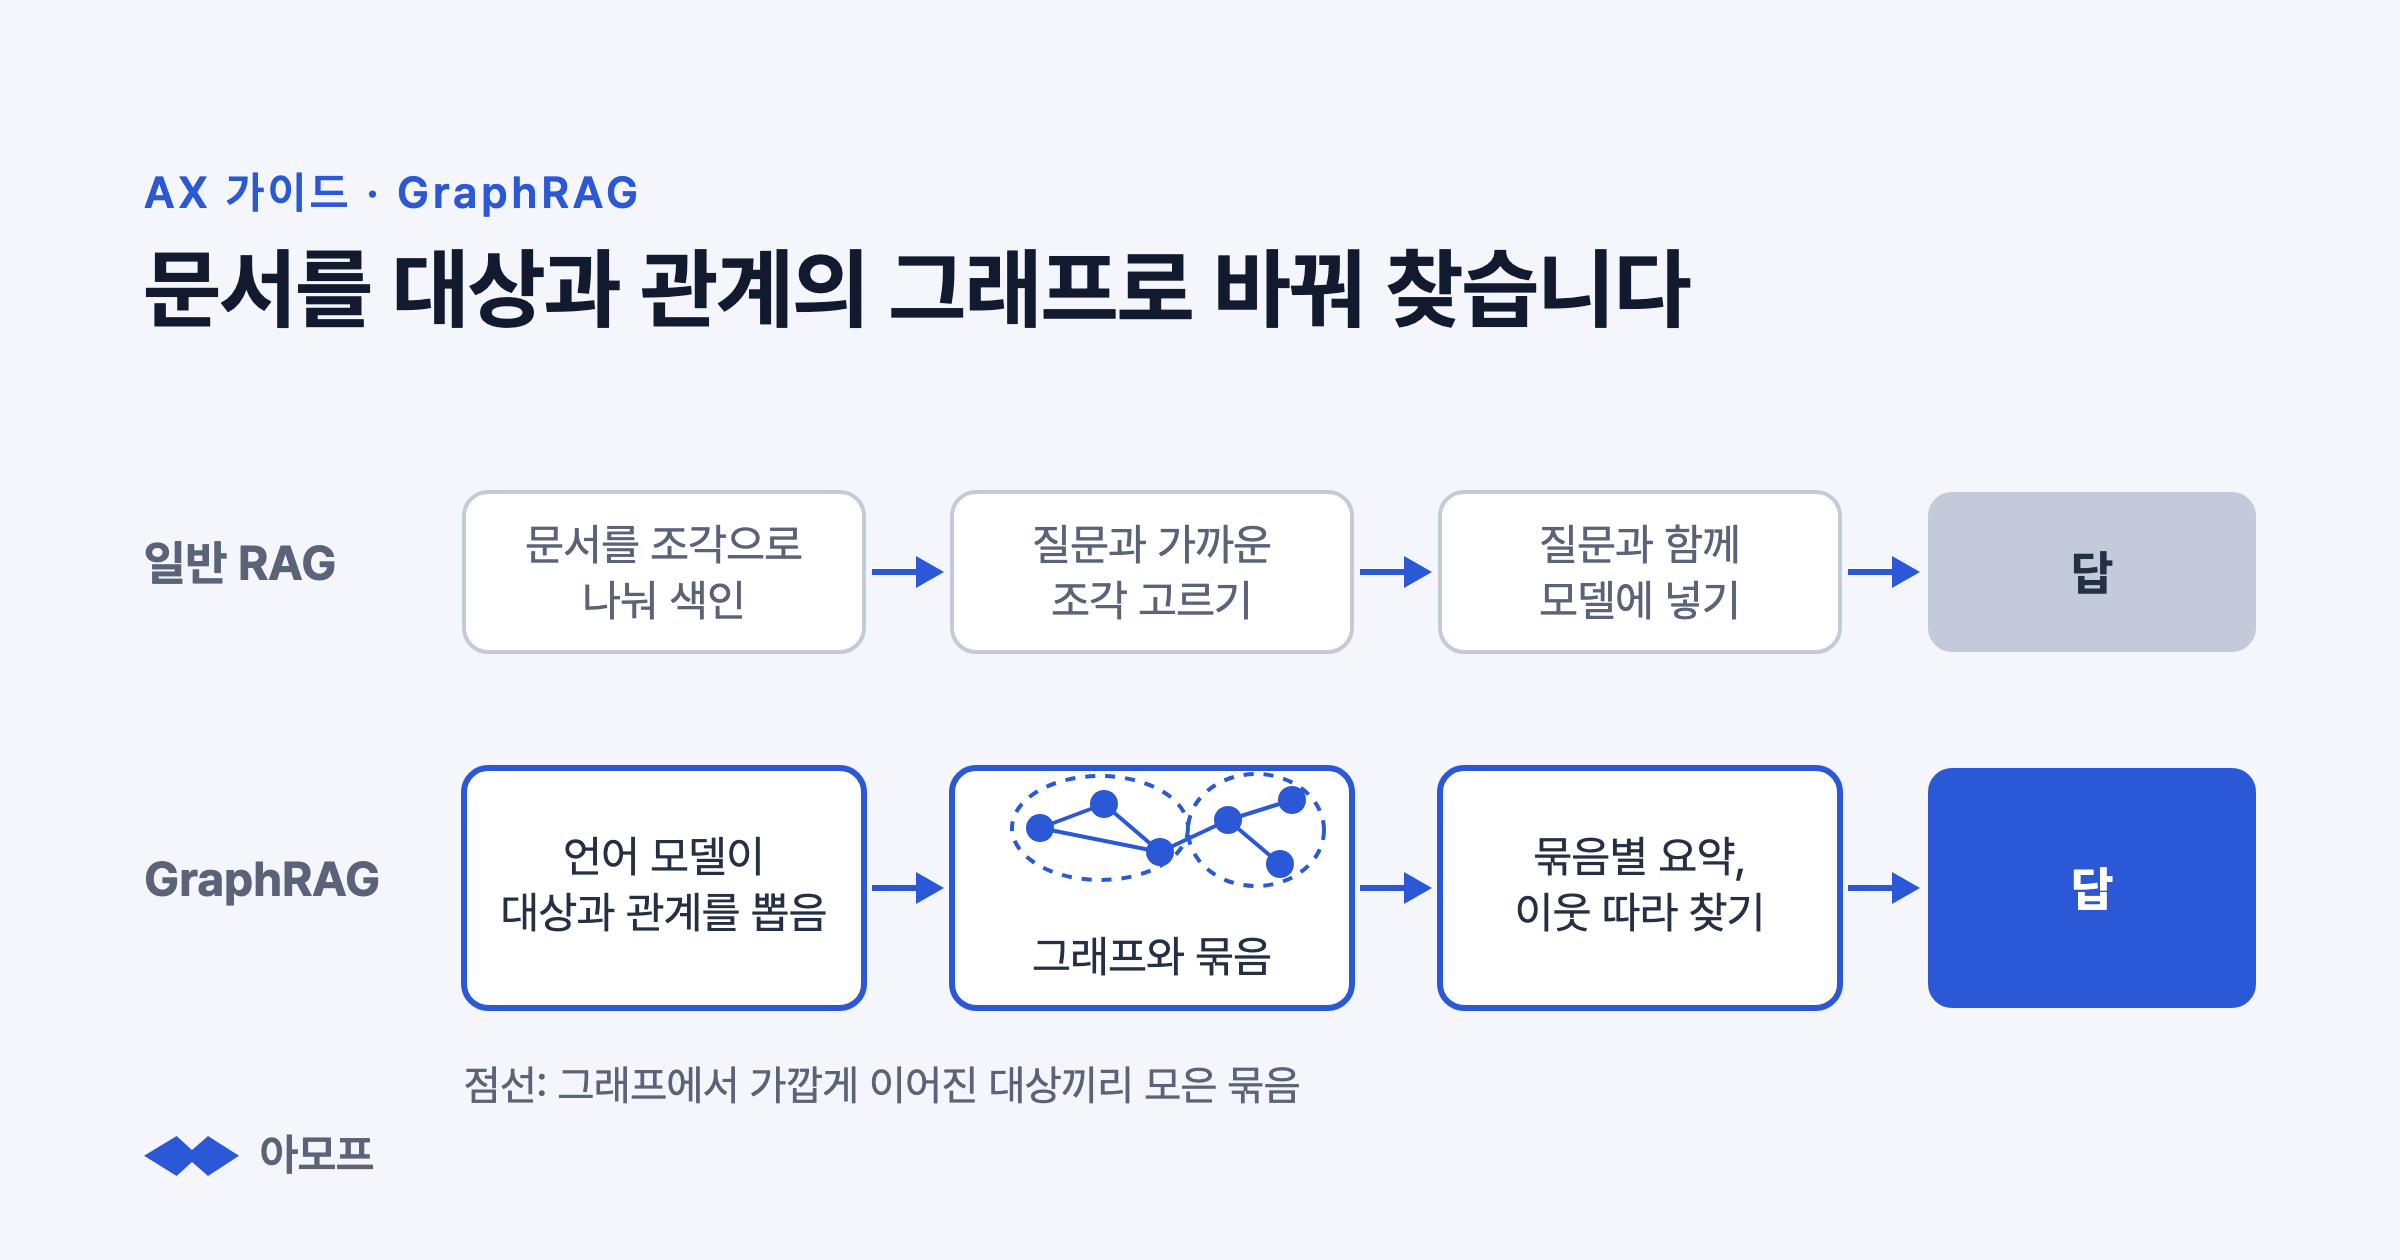
GraphRAG(그래프 RAG)는 언어 모델이 문서에서 사람, 조직, 장소 같은 대상과 그 관계를 뽑아 지식 그래프를 만들어 두고, 그 그래프를 따라 근거를 찾거나 미리 써 둔 묶음별 요약으로 답하는 RAG 방식입니다. 질문과 비슷한 문단을 찾는 일반 RAG가 약한, 자료 전체를 묻는 질문이나 여러 문서를 건너 이어지는 질문을 겨냥합니다.
RAG(검색 증강 생성)는 AI가 답을 쓰기 전에 관련 자료를 찾아 함께 읽게 하는 방식이고, 지식 그래프는 대상을 점으로, 대상 사이의 관계를 선으로 이어 사실을 담은 자료입니다. 이 방식을 제안한 Microsoft 연구진의 논문은 2024년 4월 처음 공개되고 2025년 2월 고쳐졌으며, 약 100만 토큰과 170만 토큰 규모의 자료 두 묶음으로 방법을 시험했습니다(Edge 외, 2024). 토큰은 모델이 글을 잘게 나눠 읽고 쓰는 단위입니다.
그래프가 모든 질문에 나은 것은 아닙니다. 같은 조건에서 두 방식을 비교하고 2026년 3월에 고친 판을 낸 연구는 한 문단에 답이 있는 세부 사실 질문에서는 일반 RAG가, 여러 문서를 건너야 하는 질문에서는 GraphRAG 계열이 나았다고 보고했고, 언어 모델이 만든 그래프에는 정답이 되는 대상의 약 65.8%(HotpotQA)와 65.5%(Natural Questions)만 들어 있었다고 밝혔습니다(Han 외, 2026).
GraphRAG는 일반 RAG와 무엇이 다른가요?
GraphRAG는 근거로 찾아 쓰는 대상이 일반 RAG와 다릅니다. 일반 RAG는 질문과 뜻이 가까운 문서 조각을 고르고, GraphRAG는 문서에서 뽑은 대상과 관계의 그래프, 그리고 그래프에서 가깝게 이어진 대상의 묶음마다 미리 써 둔 요약을 근거로 씁니다.
Microsoft 연구진은 "이 자료의 주요 주제는 무엇인가?"처럼 자료 전체를 묻는 질문에 일반 RAG가 약하다는 점에서 출발했습니다. 이런 질문은 답이 한 조각에 들어 있지 않기 때문입니다. GraphRAG는 묶음마다 써 둔 요약으로 각각 부분 답을 만든 뒤, 그 부분 답들을 다시 요약해 최종 답을 씁니다(Edge 외, 2024).
Microsoft가 공개한 GraphRAG 도구는 질문의 종류에 따라 검색 방식을 나눕니다. 전역 검색은 묶음별 요약으로 자료 전체에 관한 질문에 답하고, 지역 검색은 특정 대상에서 출발해 이웃한 대상과 관련 개념으로 넓혀 가며 근거를 찾으며, 기본 검색은 일반 RAG처럼 가까운 조각 몇 개를 고릅니다(Microsoft GraphRAG 문서).
정리하면 두 방식은 미리 만들어 두는 것과 잘 맞는 질문이 다릅니다.
| 구분 | 일반 RAG | GraphRAG |
|---|---|---|
| 미리 만들어 두는 것 | 문서 조각과 그 조각의 벡터(뜻을 숫자로 나타낸 목록) | 대상과 관계의 그래프, 묶음별 요약 |
| 잘 맞는 질문 | 한 문단에 답이 있는 세부 사실 질문(Han 외, 2026) | 자료 전체를 묻는 질문(Edge 외, 2024), 여러 문서를 건너는 질문(Han 외, 2026) |
| 미리 드는 비용 | 조각을 벡터로 바꾸는 비용 | 모든 조각을 언어 모델이 읽고 대상과 관계를 뽑는 비용 |
GraphRAG의 그래프는 누가 만드나요?
GraphRAG의 그래프는 대개 언어 모델이 문서를 읽고 만듭니다. Microsoft의 GraphRAG는 자료를 분석 단위인 글 조각으로 나누고, 조각마다 대상과 관계, 핵심 주장을 뽑아 그래프를 만든 뒤, 라이덴(Leiden) 알고리즘, 즉 그래프에서 촘촘히 이어진 점끼리 묶어 내는 방법으로 그래프를 여러 층의 묶음으로 나누고 아래 묶음부터 요약을 씁니다(Microsoft GraphRAG 문서).
논문의 시험에서는 팟캐스트 대본 약 100만 토큰을 600토큰 조각 1,669개로 나눴고, 앞뒤 조각이 100토큰씩 겹치게 했습니다. 이 그래프를 만드는 데 GPT-4-turbo로 281분이 걸렸습니다. 대상을 뽑는 지시문에는 그 자료의 분야에 맞춘 대상 종류와 예시를 넣었습니다(Edge 외, 2024).
뽑히는 대상의 수는 조각의 크기에 따라 달라졌습니다. 같은 논문이 HotPotQA 질문 모음의 표본으로 시험해 보니, GPT-4는 조각이 600토큰일 때 2,400토큰일 때보다 대상을 가리키는 표현을 거의 두 배 많이 뽑았고, 연구진은 놓친 대상을 다시 찾도록 이미 뽑은 대상 목록을 모델에게 돌려주는 단계도 두었습니다(Edge 외, 2024). Microsoft의 문서도 기본 설정을 그대로 쓰면 자기 자료에서 가장 좋은 결과가 나오지 않을 수 있다고 안내합니다(Microsoft GraphRAG 문서).
GraphRAG는 어떤 질문에 강하고 어떤 질문에 약한가요?
GraphRAG는 자료 전체를 아우르는 질문과 여러 문서를 건너 이어지는 질문에 강하고, 한 문단에 답이 있는 세부 사실 질문에서는 일반 RAG가 나을 때가 많습니다.
2024년 4월 처음 공개된 Microsoft 연구진의 논문은 팟캐스트 자료와 뉴스 자료에서 질문 125개씩을 두고 두 방식의 답을 언어 모델에게 판정하게 했는데, 자료 전체를 요약해 답하는 전역 방식은 답이 필요한 내용을 얼마나 빠짐없이 담았는지를 따진 비교에서 일반 RAG를 각각 72~83%, 72~80%의 비율로 이겼고, 답이 얼마나 다양한 관점을 담았는지를 따진 비교에서는 각각 75~82%, 62~71%의 비율로 이겼습니다(Edge 외, 2024). 반면 질문에 가장 곧바로 답한 쪽은 일반 RAG였습니다. 다만 언어 모델 평가자는 두 답의 순서만 바꿔도 판정이 달라질 수 있습니다. 이 치우침은 "멀티 에이전트에서는 언제 오류가 커지나요?"에서 다룹니다.
세부 질문에서는 결과가 달랐습니다. 앞의 비교 연구는 일반 RAG가 한 문단에서 답을 찾는 세부 사실 질문에서 앞섰고, 그래프를 쓰는 방식은 여러 문서를 건너야 하는 질문에서 앞섰다고 보고했습니다. 같은 연구는 요약을 대상으로 한 검색이 비교 질문과 시간 순서를 묻는 질문에서 도움이 될 수 있다고 적었습니다(Han 외, 2026). Microsoft도 일반 RAG는 특정 사실을 묻는 질문에 강하고, 자료 전체를 묻는 질문에는 GraphRAG의 전역 검색이 필요하다고 설명합니다(Microsoft Research, 2024).
예시로 "지난 3년 동안 불량의 주된 원인은 무엇이었나요?"는 여러 보고서를 아울러야 하므로 GraphRAG의 전역 검색이 맞고, "펌프의 정비 주기는 몇 시간인가요?"는 매뉴얼 한 문단에 답이 있으므로 일반 RAG로 충분합니다.
GraphRAG의 그래프가 틀리면 답은 어떻게 되나요?
그래프에 빠졌거나 잘못 이어진 사실은 답에서도 빠지거나 틀립니다. GraphRAG의 답은 그래프와 그 그래프로 쓴 요약을 근거로 삼기 때문입니다.
빠지는 사실은 생각보다 많을 수 있습니다. 앞의 비교 연구에서 언어 모델이 만든 그래프에는 정답이 되는 대상이 HotpotQA 질문 모음에서 약 65.8%, Natural Questions 질문 모음에서 약 65.5%만 들어 있었습니다(Han 외, 2026). 나머지 대상을 묻는 질문은 그래프만으로는 답할 수 없다는 뜻입니다.
같은 대상이 다른 이름으로 뽑히는 문제도 있습니다. Microsoft의 논문은 이름이 글자 그대로 같을 때만 같은 대상으로 합쳤다고 밝히고, 더 느슨하게 맞추는 방법도 쓸 수 있으며, 중복된 대상은 대개 같은 묶음에 모여 요약되므로 GraphRAG가 중복에 대체로 잘 견딘다고 적었습니다(Edge 외, 2024). 다만 특정 대상에서 출발하는 지역 검색에서는, 예시로 「한빛기계」와 「한빛기계(주)」가 두 점으로 나뉘면 그 회사에 관한 근거도 두 곳으로 흩어질 수 있습니다. 같은 대상을 가리는 기준이 왜 필요한지는 "지식 그래프란? 뜻과 시소러스·택소노미와의 차이"에서 다룹니다.
묶음별 요약도 언어 모델이 쓰므로, 요약에 섞인 오류는 그 요약을 근거로 쓴 답에 그대로 들어갈 수 있습니다. Microsoft의 논문도 답에 지어낸 내용이 섞인 비율을 비교하면 분석이 더 탄탄해질 것이라고 한계로 적었습니다(Edge 외, 2024).
문서가 바뀌면 그래프를 다시 만드는 비용도 생각해야 합니다. 앞의 비교 연구에서 MultiHop-RAG라는 질문 모음의 색인을 만드는 데 걸린 시간은 일반 RAG가 135초였고, 그래프를 쓰는 방식은 묶음별 요약을 만드는 방식이 5,560초, 지식 그래프에서 근거를 찾는 방식이 7,702초였습니다(Han 외, 2026). Microsoft는 이런 비용을 줄이려고 2024년 11월, 색인 비용을 일반 RAG와 같은 수준이자 원래 GraphRAG의 0.1%로 줄인 LazyGraphRAG를 발표했습니다(Microsoft Research, 2024).
RAG의 기본부터 보려면 무엇을 읽으면 되나요?
RAG가 답을 만드는 순서와 한계는 "RAG란? 검색 증강 생성의 뜻과 작동 순서, 한계"에, 그래프에 담기는 지식 그래프의 뜻은 "지식 그래프란? 뜻과 시소러스·택소노미와의 차이"에 정리했습니다. 다른 질문은 AX 가이드의 지식 구조에서 찾을 수 있습니다.
이 글의 근거와 한계
GraphRAG의 정의와 시험 결과는 Microsoft 연구진의 논문(Edge 외, 2024년 4월 처음 공개, 이 글은 2025년 2월판을 따름)과 GraphRAG 공식 문서, 2024년 11월 Microsoft Research 블로그를, 두 방식의 비교는 Han 외(2026년 3월판)를 따랐고, 모두 2026년 11월 4일에 원문을 확인했습니다. 수치는 각 연구가 쓴 모델과 영어 자료에서 나온 값이어서, 한국어 사내 문서에서도 같은 크기로 나타난다고 볼 수는 없습니다. 불량 원인과 정비 주기 질문, 회사 이름은 설명을 위해 지어낸 예시입니다.